

(Ре)дизайн промышленных и терапевтических белков: от слепого перебора к навигации в белковой вселенной
25 сентября 2026
(Ре)дизайн промышленных и терапевтических белков: от слепого перебора к навигации в белковой вселенной
- 13
- 0
- 0

Все началось в 2019-м с одной нейросети, читавшей белок как текст.
За несколько лет вокруг нее выросла целая мастерская редизайна с инструментами на все случаи жизни.Рисунок в оригинальном разрешении.
иллюстрация Виктории Шарманкиной
-
Автор
-
Редакторы
-
Рецензент
-
Иллюстратор


Десятилетиями практическая белковая инженерия полагалась на направленную эволюцию — мощный, но слепой метод перебора тысяч случайных мутаций в пробирке. Сегодня правила игры меняются: эволюция переносится в компьютер. В этой статье (входящей в цикл «ИИ в биологии») мы проследим путь от хаоса к контролю над белковой эволюцией: начнем с тонкой настройки одиночными мутациями, а после научимся различать белки по нужным свойствам. Прогуляемся по белковой вселенной, вылавливая новые белки. Под конец станем переписывать белки по пространственному чертежу, как настоящие инженеры. Увидим, откуда берутся ферменты для промышленности и антитела для клиники, и разберемся, чем отличаются дизайн белков de novo (тот самый, за который дали Нобелевскую премию) и более приземленный, но зато уже прочно вошедший в практику редизайн.
Разбирается в этой сложной области автор «Биомолекулы» Андрей Кузнецов с помощью Елены Кудряшовой — руководителя Лаборатории таргетной терапии и предиктивной диагностики Центрального университета.
Искусственный интеллект в биологии
Спецпроект о том, как ИИ меняет современную молекулярную биологию: какие исследовательские задачи он позволяет решать принципиально иначе, какие новые подходы формирует и какие научные результаты уже удалось получить благодаря его применению.
Партнер спецпроекта в 2026 году — Центральный университет (ЦУ), инновационный российский вуз, внедряющий STEM-подход (Science, Technology, Engineering and Mathematics) в высшее образование. В ЦУ наука ориентирована на путь от фундаментальных исследований к продукту — ученые создают прототипы, вычислительные методы и практические подходы. Запущены девять лабораторий и программа трансляционных исследований, где научные группы получают грант до 5 миллионов, менторскую поддержку и взаимодействие с индустрией.
Исходно спецпроект стартовал с научно-исследовательским Институтом искусственного интеллекта AIRI, объединяющим ученых и инженеров данных. Институт активно развивает партнерства между академическим сообществом, промышленностью и образовательными организациями.
На ощупь: инженерия до ИИ
Теоретически возможных белков невообразимо много: даже у короткой цепочки в сотню аминокислот вариантов последовательности больше, чем атомов во Вселенной (20100 ≈ 10130). Из этого поистине безбрежного океана природа миллиарды лет скрупулезно отбирала не просто рабочие варианты, а те, которые помогали своему хозяину выжить и передать гены дальше. Именно так работает естественный отбор, отлично настроивший белки под жизнь в клетке: под определенную температуру, кислотность, концентрацию солей, а также под тесное соседство с другими молекулами — поверхности белков [1] ювелирно подогнаны под субстраты, другие белки, мембраны.
Поэтому, стоит вынуть белок из клетки и лишить его привычного окружения, как все начинает сыпаться. В промышленности фермент, идеально сворачивающийся при 37 oC, разваливается в горячем реакторе с органическими растворителями и нефизиологичным pH. В медицине антитело, отлично связывающее мишень, слипается в комки в высоких концентрациях и вызывает иммунный ответ. Среда биореактора или фарм-ампулы имеет мало общего с внутриклеточной, и под эту чужую среду природный белок никем и никогда не оптимизировался — у отбора просто не было такой задачи [2].
Подступиться к этой проблеме можно с двух сторон. Можно не трогать природные белки вовсе: нарисовать форму, которой в природе никогда не существовало, и подобрать последовательность, которая в нее свернется. Это дизайн de novo [3], за который в 2024 году дали Нобелевскую премию по химии [4]. Выглядит потрясающе, потенциал огромный, но сегодня это скорее красивая демонстрация, чем рабочий инструмент: рутинно закрывать промышленные задачи так пока не получается.
А можно взять уже существующий белок и приспособить его к новым условиям: поднять термостабильность, подкрутить активность, повысить растворимость, снизить агрегацию или иммуногенность. Нереализованный потенциал в молекуле, как правило, уже есть — эволюция его просто не искала, потому что спроса не было. Наша задача — этот потенциал разглядеть и раскрутить [2]. На таком редизайне биотех живет уже несколько десятилетий — и сегодня мы расскажем, какую трансформацию этот подход претерпевает в последние годы, заметно перенося фокус из пробирки (in vitro) в компьютер (in silico).
Стойкие белки для промышленности
Самый частый запрос промышленности к белку — термостабильность, то есть устойчивость его рабочей конформации. Работу делает не сама последовательность аминокислот, а точная геометрия свернутой конструкции: каталитические остатки должны позиционироваться с точностью до долей ангстрема — иначе реакция не пойдет. Свернутый белок можно представить как собранный трехмерный пазл — вот только пазл не жесткий: в растворе структура «дышит», боковые цепи чуть смещаются, и достаточно легкого разупорядочивания, чтобы детальки активного центра и субстрата перестали подходить, как ключ к замку [5].
Держится этот пазл на удивление слабо: правильно свернутая форма выгоднее развернутой всего на несколько десятков кДж/моль — эквивалент буквально нескольких водородных связей [2], [6]. Это свойство называют маргинальной стабильностью: белок стабильнее ансамбля развернутых и полуразвернутых форм совсем немного, впритык. Клетке такой стабильности хватает, а вот реактору, где реакцию часами гоняют в агрессивной среде при высокой температуре, — нет: хлипкий пазл сразу рассыпается. Поэтому задача редизайна — сделать нативную конформацию достаточно жесткой, чтобы детали не вылетали.
Иногда для этого хватает одной замены. Так, например, у субтилизина — протеазы, которую добавляют в стиральный порошок, чтобы тот отстирывал белковые пятна, — есть уязвимое место: метионин, сидящий вплотную к каталитическому остатку. В отбеливателе он быстро окисляется, и фермент теряет активность. В 1985 году перебрали все возможные замены этого метионина, три из которых — аланин, серин и лейцин — позволили ферменту спокойно переживать то, что раньше его убивало (рис. 1) [7].
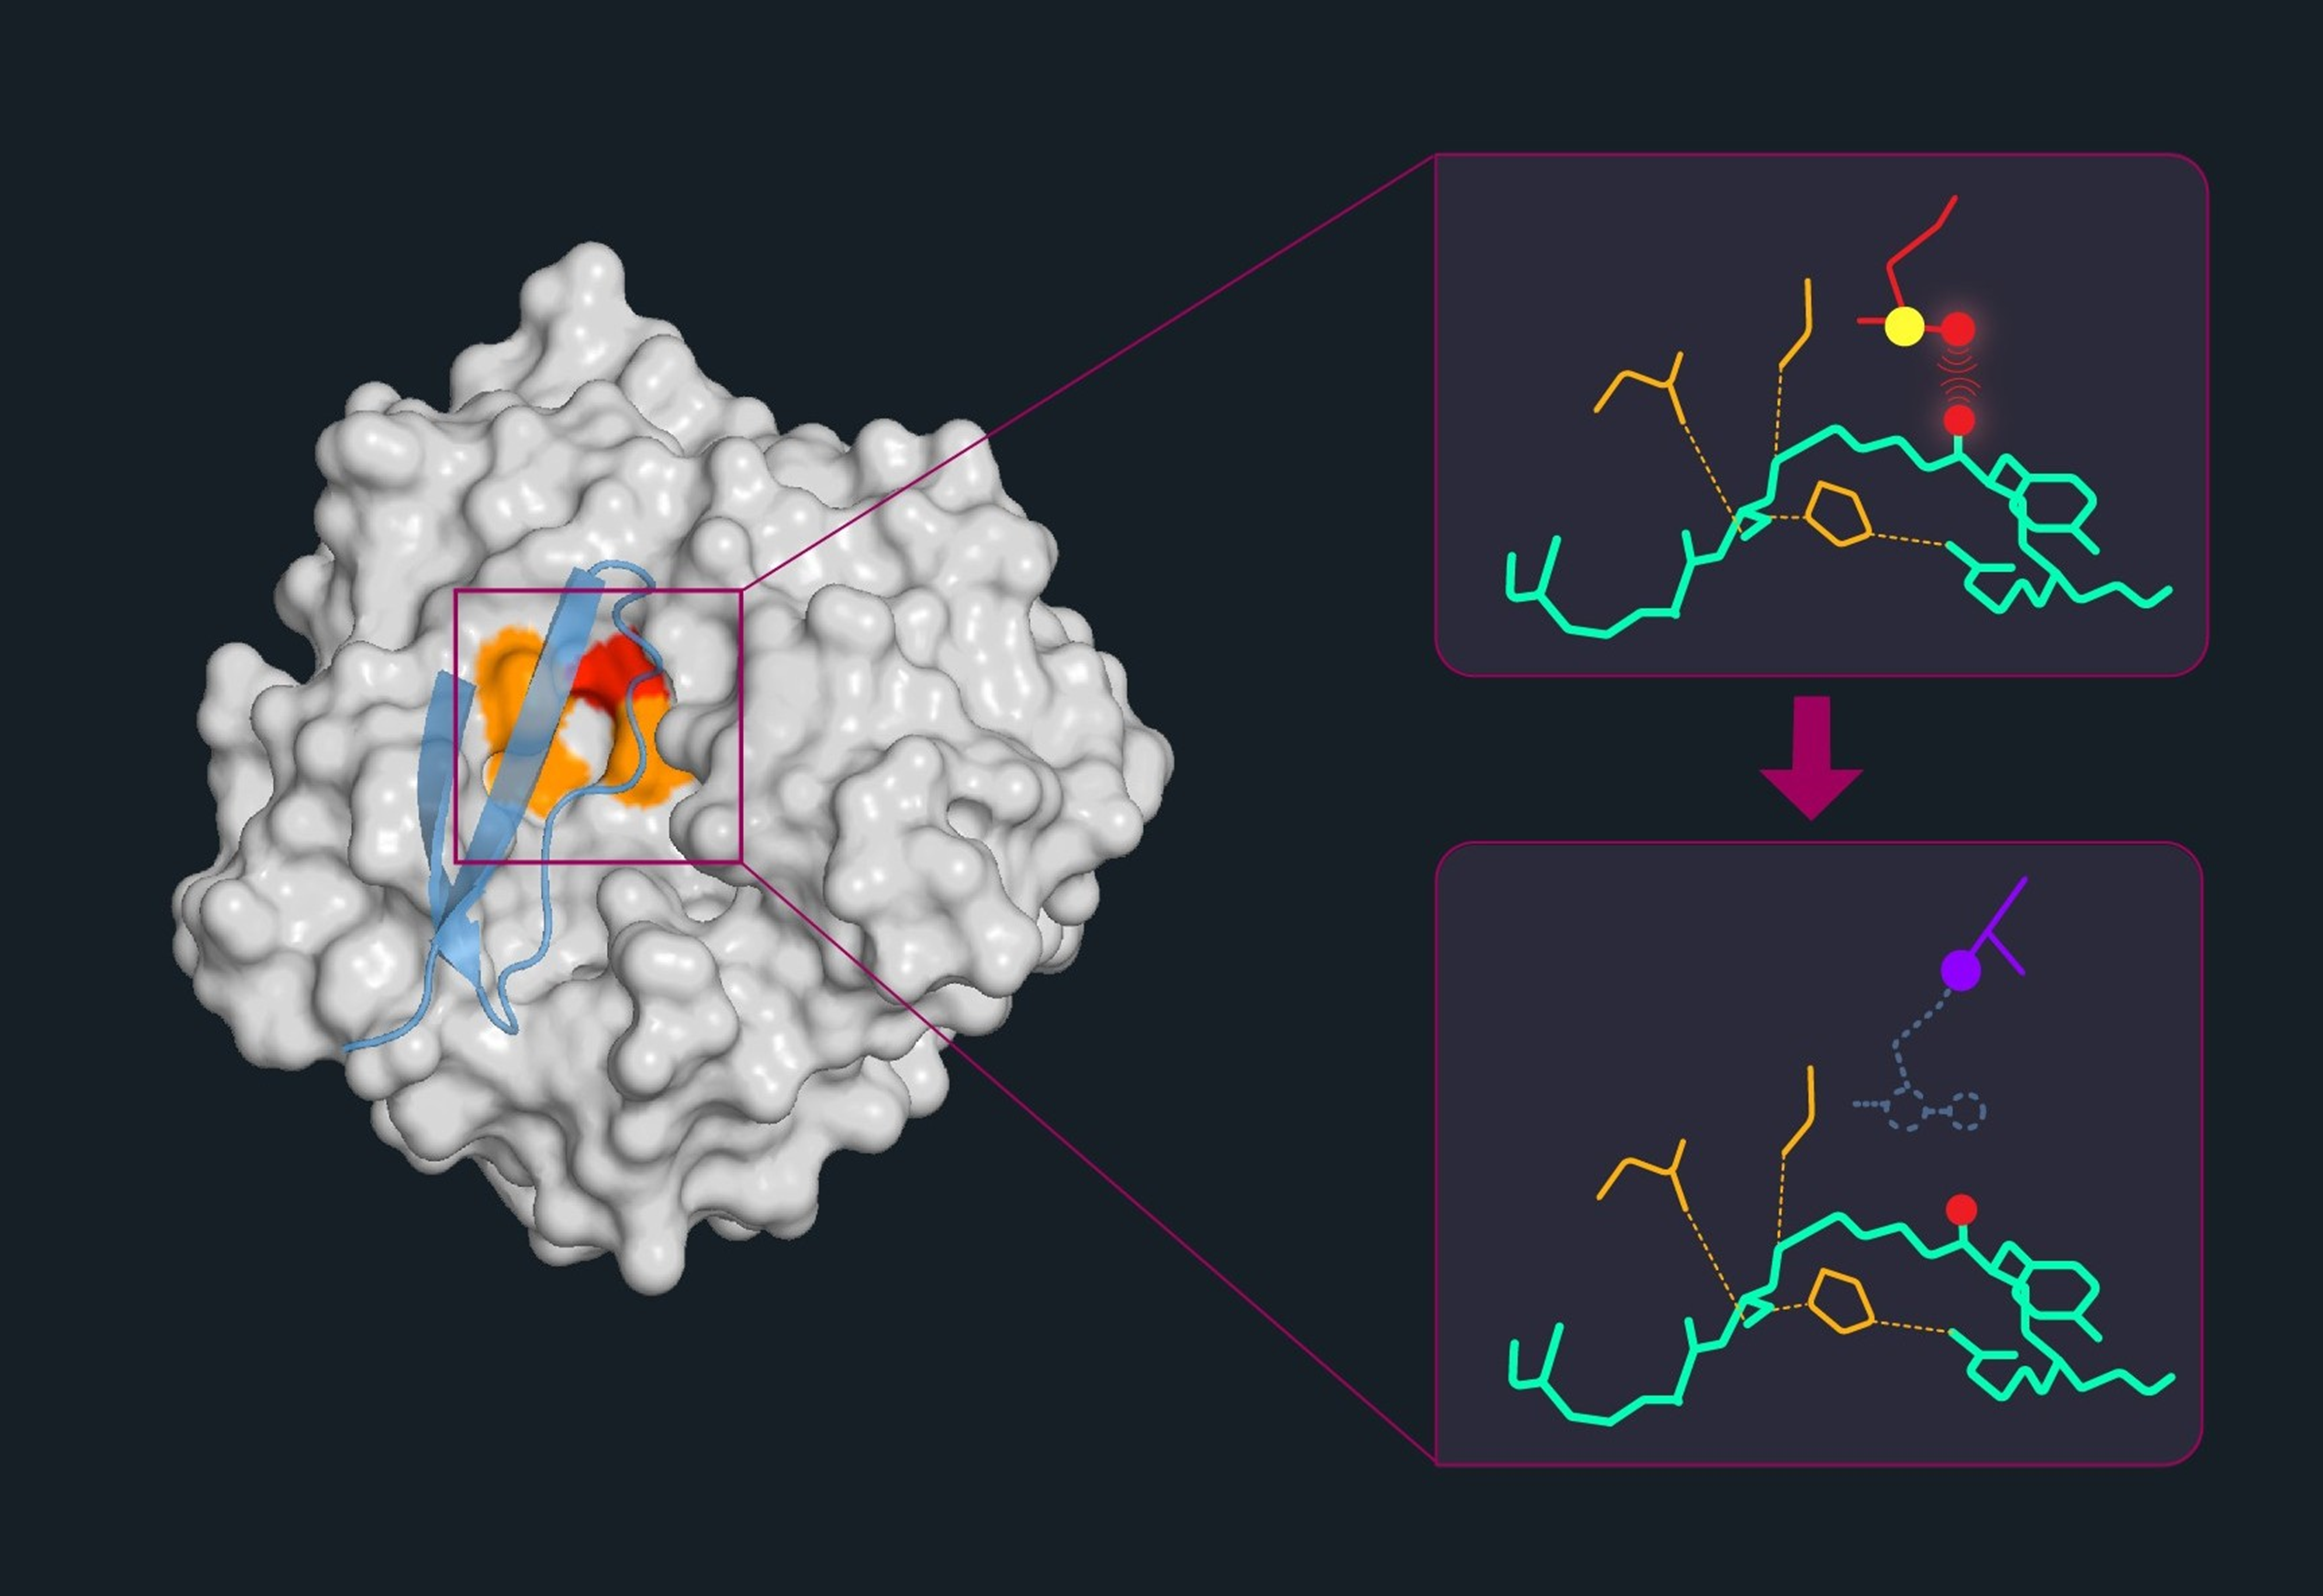
Рисунок 1. Одна замена в субтилизине — условие сохранения активности при стирке. Слева — поверхность фермента с белковым загрязнителем в бороздке активного центра, где его разрезает каталитическая триада. Метионин-222 сидит вплотную к ней, но сам в катализе не участвует. Справа — тот же участок вблизи: пунктиром показаны контакты (как правило, водородные связи), которыми фермент придерживает субстрат. Сверху — метионин после окисления отбеливателем: сера получает лишний сульфоксидный кислород, который оказывается там же, куда должен был лечь карбонильный кислород разрезаемой пептидной связи, и два электроотрицательных атома отталкиваются — переходное состояние перестает стабилизироваться, и фермент почти не работает. Снизу — вариант с аланином, а поверх него тонкая призрачная линия — контур метионина, который здесь стоял: окисляться больше нечему, и фермент спокойно работает в агрессивной среде, хоть и медленнее оригинального. Одна замена из 275 позиций — и уязвимости нет.
иллюстрация Виктории Шарманкиной по структуре pdb 2SNI (в реальности это комплекс не с субстратом, а с ингибитором субтилизина: он садится в бороздку фермента в точности как субстрат, но не разрезается, поэтому существует его кристаллическая структура)
Раз запас прочности в молекуле явно есть, почему же рабочая конформация держится на честном слове? Потому что естественному отбору устойчивые молекулы не нужны, а порой и вредны. Во-первых, как только белок перевалил порог, ниже которого перестает работать, дальнейшее упрочнение не дает организму никакого преимущества — и отбор перестает этот признак защищать. Во-вторых, несокрушимый белок клетке неудобен: отработавшую молекулу надо вовремя выключить и разобрать на аминокислоты, а неубиваемый булыжник так просто не утилизируешь. В-третьих — и это главное — жесткость мешает работать: во время катализа фермент дышит, домены сходятся и расходятся, петли над активным центром открываются и закрываются; между тем, зашитая намертво молекула теряет подвижность, а с ней активность и регулируемость — что и случилось с субтилизином, который после замены метионина стал куда устойчивее, но потерял в активности [7].
Поэтому отбор на стабильность ослабевает, накапливаются нейтральные мутации, потихоньку подгрызающие прочность, но не трогающие функцию [8]. Такой размен стабильности на активность называют stability—activity trade-off: для клетки он выгоден, для реактора — катастрофа. И из этого размена дальше будут вытекать основные трудности редизайна.
Внутри клетки шаткость конструкции сходит с рук еще и потому, что белку помогают шапероны: они следят за правильным сворачиванием и не дают молекулам слипаться (подробнее о них читайте в материале «Война и мир: как устроить белковую жизнь?» [9]). В ампуле или реакторе этой подстраховки нет, и белок остается один на один со своей нестабильностью. Поэтому цель редизайна — углубить энергетическую яму нативной формы: сделать правильную конформацию настолько выгоднее развернутых соседей, а выход из ямы к мисфолдам (неправильно свернутым белкам) и агрегатам — настолько трудным, чтобы белок не сползал в них даже в агрессивной среде без шаперонов (рис. 2).
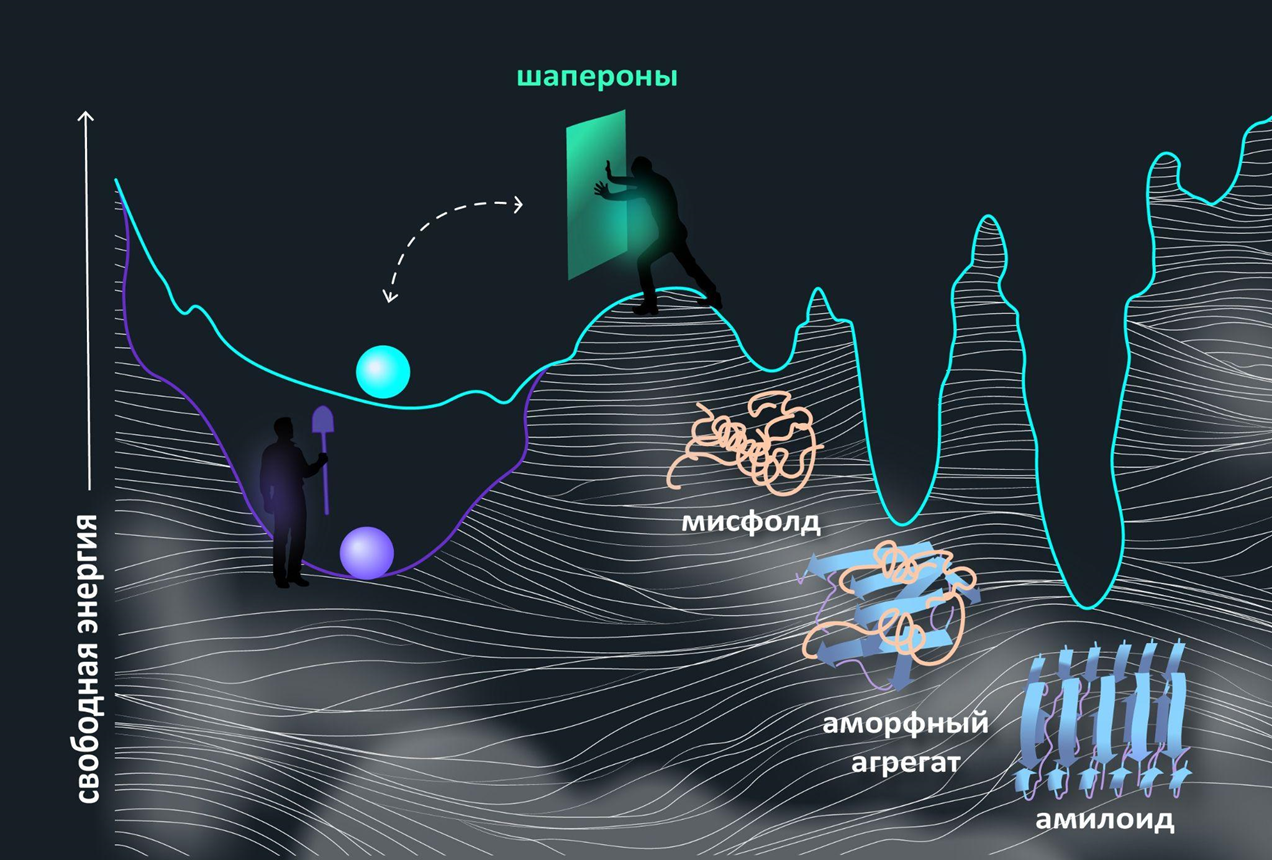
Рисунок 2. Редизайн углубляет энергетический минимум нативной формы. Энергетический ландшафт природного белка таков, что ● правильно свернутая нативная форма сидит в неглубокой яме, а по ее склонам лежит множество развернутых и полуразвернутых конформаций. Выгоднее их она совсем ненамного — это и есть маргинальная стабильность. Поэтому белок постоянно дышит и слегка разворачивается, катаясь по дну ямы, — а нагрев раскачивает его так сильно, что он все чаще забирается по склону и вываливается за край, где начинается целая гряда ловушек. Мисфолды, аморфные агрегаты и амилоиды могут лежать еще ниже: относительно них нативная форма уже менее стабильна, и, скатившись туда, белок не вернется обратно. В клетке его удерживают в яме шапероны, запирающие выход, как дверь. Ландшафт после удачного редизайна отличается энергетической ямой нативной формы: она оказывается настолько глубокой, что ее собственные склоны работают барьером — подняться по ним до края и вывалиться теперь куда труднее. ● Тот же белок держится в ней сам — без шаперонов и даже в агрессивной среде реактора.
иллюстрация Виктории Шарманкиной
Воскресить термофильных предков
Но так было не всегда. На молодой горячей Земле держать форму при высокой температуре приходилось по умолчанию, и баланс смещался в сторону стабильности. Древние белки протоклеток и организмов вроде LUCA в среднем были устойчивее нынешних [10], [11]. Стабильность они растеряли позже, когда по мере усложнения метаболизма жизни понадобились быстрые и управляемые ферменты, и потомки разменяли прочность на скорость, специфичность и регулируемость.
Эту древнюю устойчивость можно вернуть двумя путями. Первый — найти тех, кто ее не разменивал. Термофилы из горячих источников и глубоководных гидротерм так и живут при высоких температурах, и их ферменты можно просто позаимствовать. Так вышло с Taq-полимеразой, без которой не было бы ПЦР [12] — а значит, и половины современной молекулярной биологии. Обычная полимераза плохо переносит высокие температуры, и после каждого нагрева до 95 oC, которым разделяют цепи ДНК, она разваливается. Решение нашлось в горячем источнике Йеллоустоуна: из жившей там термофильной бактерии Thermus aquaticus выделили полимеразу, для которой 95 oC — рабочая температура. Такой прием называют биопроспектингом: метагеномные базы перебирают в поисках ферментов из горячих источников, соленых озер и кислых стоков. Но работает он только там, где наш интерес случайно совпал с эволюционным. Стоит захотеть фермент, который природе нужен не был, — и искать становится негде.
Второй путь — если нужного термофила не нашлось — воскресить предковую форму. Построив филогенетическое дерево семейства и пройдя по нему от листьев к корню, можно восстановить наиболее вероятную предковую последовательность. Метод называется ASR (ancestral sequence reconstruction) и позволяет находить варианты, на десятки градусов термостабильнее современных родственников [13]. Но, как мы говорили раньше, предки платили за стабильность скоростью и специфичностью, а у менее разборчивого фермента больше нежелательных побочных реакций. На производстве это дополнительные траты на очистку продукта. А в клинике лишняя реакция — это уже вопрос безопасности. Например, противоопухолевая аспарагиназа расщепляет заодно и глутамин — самую мажорную аминокислоту плазмы. Клетки лишаются нужного субстрата, а в кровь выбрасывается лишний аммиак [14]. С этим связаны многие побочные эффекты, поэтому отдельная задача редизайна — убрать эту активность, не потеряв основную.
И биопроспектинг, и ASR — это перебор в рамках того, что эволюция уже пробовала [13]. Если же нужен вариант, которого на Земле никогда не было, придется менять белок самостоятельно. Но мы редко знаем молекулу настолько хорошо, чтобы прямо указать, какую букву нужно заменить, а случай с субтилизином — скорее счастливое исключение.
Слепой перебор: от пробирки к компьютеру
Раз точное место неизвестно, первые десятилетия белковой инженерии биотехнологи просто повторяли прием природы — вели направленную эволюцию: в ген вносят случайные мутации, получают тысячи вариантов, проверяют их в лаборатории и оставляют лучшие; а затем цикл повторяют. Так, цитохром c заставили сшивать атомы углерода и кремния — реакцию, которой в природе не существует. Кремнийорганика интересна фармацевтике тем, что замена одного атома углерода на кремний уже меняет метаболизм и селективность готового лекарства. Например, у сила-галоперидола — кремниевого двойника антипсихотика галоперидола [15] — выше сродство к D2-рецептору, другая избирательность по его подтипам и совсем другой путь распада в организме [16]. Прежде химики проводили эту реакцию с дорогими родиевыми и иридиевыми катализаторами — эволюционировавший фермент справлялся с ней раз в пятнадцать эффективнее [17]. За направленную эволюцию в 2018 году Нобелевскую премию по химии получила Фрэнсис Арнольд [18]. Вторую половину разделили Джордж Смит и Грегори Уинтер — за фаговый дисплей, где отбор идет не по активности, а по связыванию. Из этого выросла целая индустрия антительных лекарств, первым из которых стал адалимумаб [19].
Синтезировать и проверять каждый вариант достаточно дорого, а перебирать приходится тысячами. Логично перенести перебор в компьютер. Так появилась Rosetta: она перебирает мутации методом умного Монте-Карло, оценивая их по внутренней энергии (подробнее про устройство Rosetta — в статье «Конструкторское бюро белков» [20])
Это уже быстрее и дешевле пробирки, но физика в расчетах приближенная, а главное — Rosetta по-прежнему не знает, где искать: она честно перебирает варианты, просто делает это в компьютере, а не в пробирке.
Хочется сузить поиск — заранее отсечь заведомо неудачные замены и оставить перспективные. Подсказку опять дает эволюция. Если выровнять сотни родственных последовательностей, то видно, какие аминокислоты в каждой позиции встречаются чаще, а какие — реже. То, что эволюция пробовала много раз и не выбросила, скорее всего, не сломает укладку. Так устроен PROSS: он строит выравнивание гомологов и проверяет с помощью Rosetta только одобренные эволюцией замены, отбирая стабилизирующие [22].
До сих пор мы двигались двумя способами. Либо шли по тропинкам, которые эволюция уже протоптала, — пользуясь тем, что она успела перебрать. Либо прокладывали путь сами, двигаясь наугад, на ощупь в пространстве последовательностей — как в тумане, где дальше одного шага ничего не видно. Чтобы переписывать последовательности направленно, а не вслепую, нужно выучить язык белков — правила, по которым из цепочки аминокислот получается работающая структура. Этот язык и освоили языковые модели, обученные на сотнях миллионов природных последовательностей. В биологию эти алгоритмы пришли из обработки текста, и для хорошего понимания того, что написано дальше, мы рекомендуем изучить материал: «Как языковые модели покорили мир белков» [24].
Дальше нас ждут три грани биохимической реальности. Сначала мы будем перебирать мутации в пространстве последовательностей, имитируя выбор эволюции; потом мы раскрасим его в цвета различных белковых свойств и, заручившись настраиваемым компасом, будем искать нужные из них. После мы перейдем в более абстрактное латентное пространство: начертим карту семейства белков, по которой можно гулять и вылавливать рабочие белки. И наконец — вынырнем в пространство форм, где от белка останется только идея: его пространственный чертеж, по которому мы сможем пересобрать хоть половину молекулы.
Фонари в тумане: пространство последовательностей
1-ая остановка из 4 · Фонари: идем по следам эволюции.
иллюстрация автора, созданная с помощью Grok
Эволюция оставила нам огромный архив — миллионы работающих последовательностей, то есть миллионы уже пройденных эволюционных маршрутов. И если найти закономерности, по которым она их прокладывала, эти маршруты можно превратить в подсказки — вроде фонарей-ориентиров, расставленных в тумане пространства последовательностей.
Именно этим и занимаются белковые языковые модели (БЯМ или PLM) [24]. Обычная модель, как в GPT, предсказывает, какое слово поставил бы человек; белковая — какую аминокислоту поставила бы эволюция. Причем не одну-единственную: для каждой позиции белка модель как бы зажигает двадцать лампочек разной яркости — по одной на каждую аминокислоту; чем аминокислота вероятнее, тем ярче фонарь. Такое распределение вероятностей — это карта толерантности, подсказывающая, где остаток жестко зафиксирован эволюцией (горит один яркий фонарь), а где допускаются замены (тускло тлеет сразу несколько) (рис. 3).
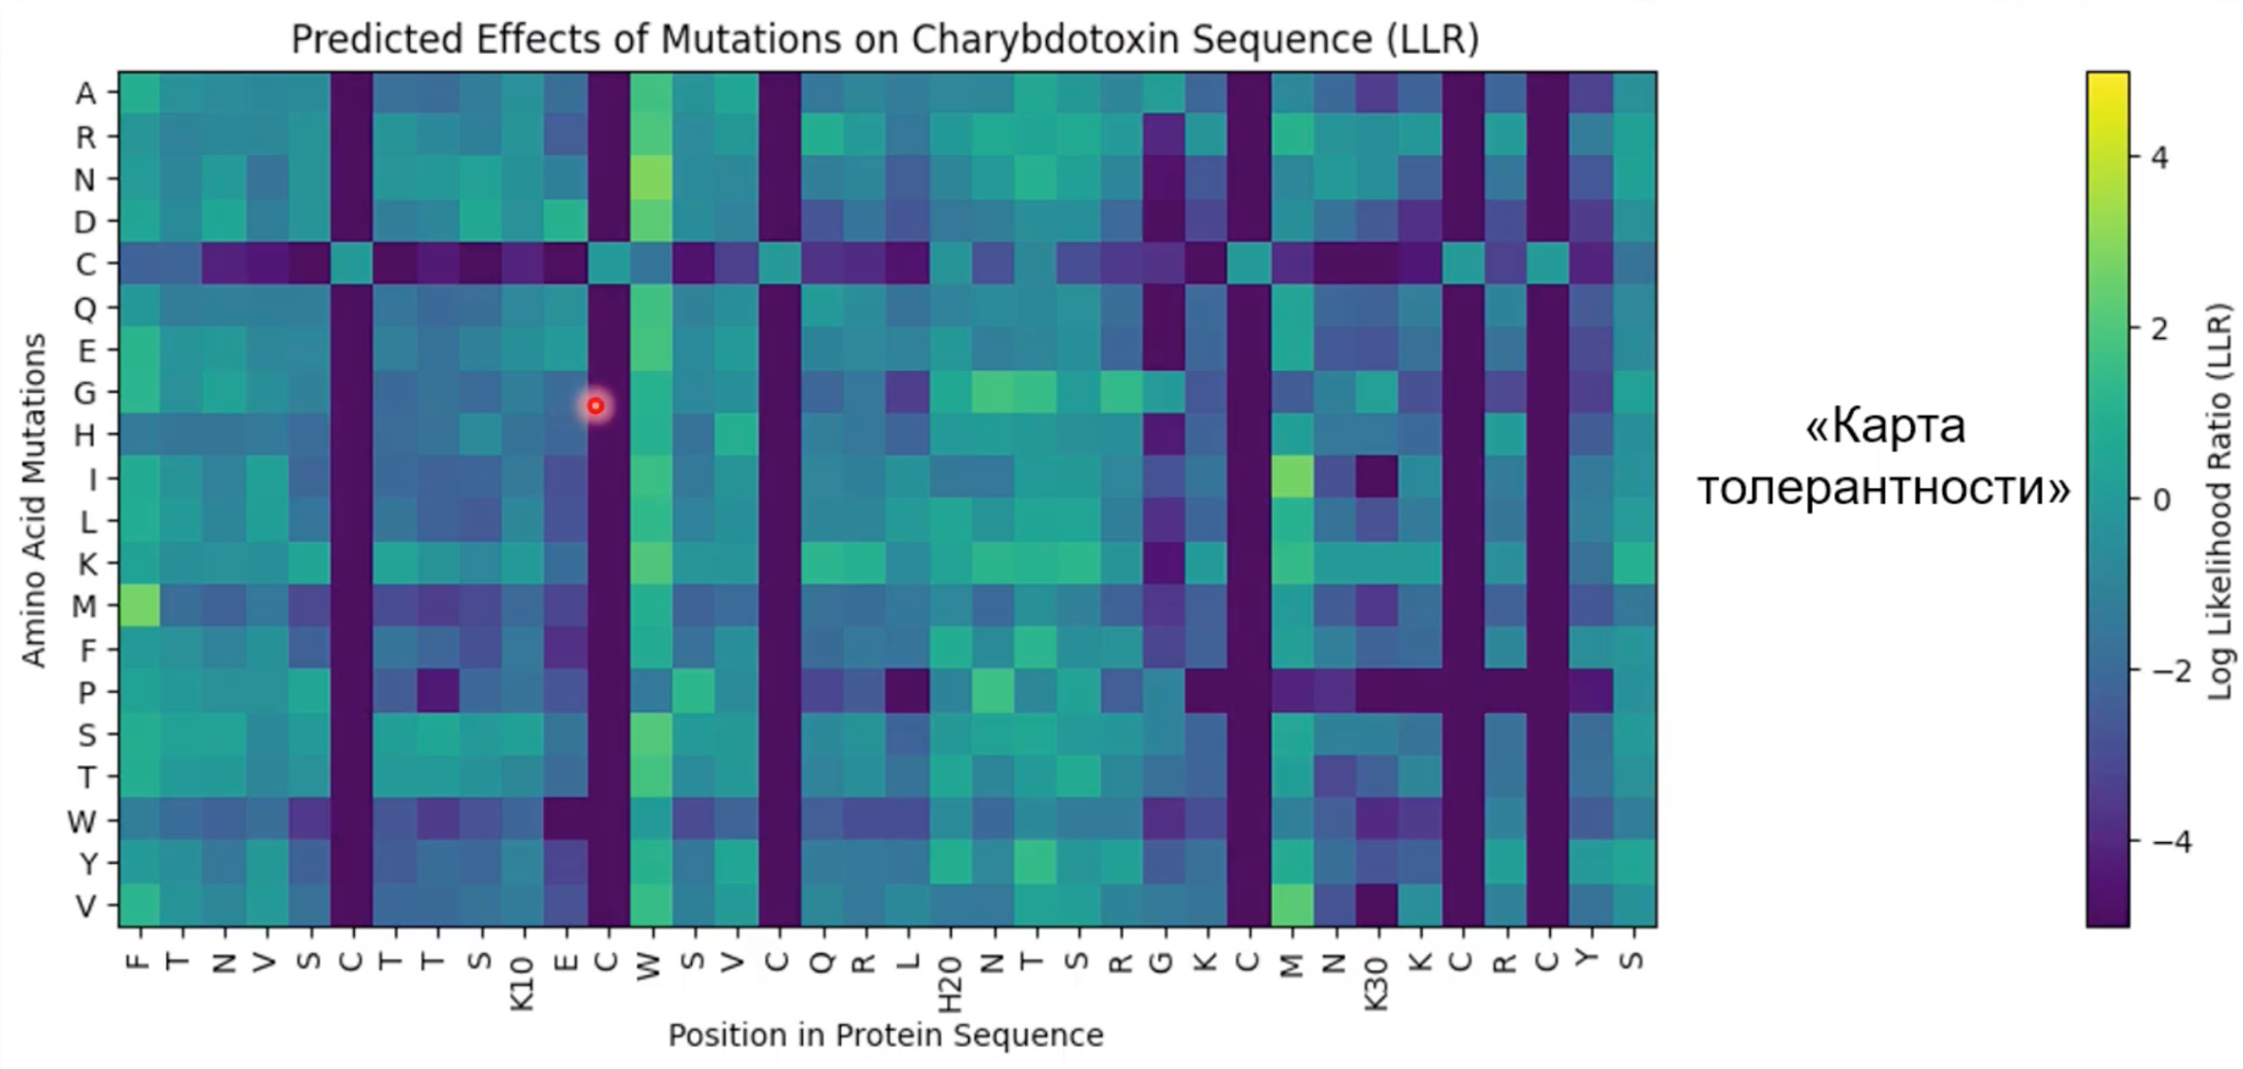
Рисунок 3. Карта толерантности показывает, где эволюция разрешает замену, а где держит позицию намертво. Слева по вертикали — все 20 возможных аминокислот; снизу по горизонтали — номер позиции в цепочке и последовательность изучаемого белка. Это харибдотоксин: пептид из яда скорпиона Leiurus quinquestriatus, блокирующий потенциал-чувствительные калиевые каналы [28]. Чем светлее пиксель, тем вероятнее аминокислота в этой позиции. Шесть вертикальных темных полос в последовательности пептида — консервативные дисульфидные связи (между остатками цистеина: С—С), на которых держится вся молекула.
«Белковый дизайн» — 8-я лекция из курса «Новости компьютерного моделирования биосистем», который редактор этой статьи читает в МФТИ (также доступна в YouTube)
Чтобы понять, какая аминокислота подходит лучше, модель сначала смотрит на ее окружение и распределяет соседей по «важности» — насколько сильно они связаны с этой позицией. А потом сворачивает каждый остаток вместе с его окружением в набор чисел — эмбеддинг. И чем важнее сосед, тем сильнее модель его учитывает, когда формирует эмбеддинг. Примерно так работает механизм внимания — attention. Получается сжатая сводка всего, что модель поняла про данную позицию: у похожих по окружению остатков и эмбеддинги окажутся похожими. Уже из эмбеддинга модель рассчитывает вероятности аминокислот.
Антитела: дозревание в компьютере
Хорошо видно, как это работает, на примере антител. Благодаря своей почти абсолютной избирательности они составляют основную массу современных биопрепаратов [29]. Рынок моноклональных антител оценивается в сотни миллиардов долларов в год, а самым продаваемым лекарством в мире долгие годы оставался адалимумаб — антитело, направленное против TNF-α (фактора некроза опухоли), с которого начинается воспаление при ревматоидном артрите, псориазе и болезни Крона. За подробностями отправляем в спецпроект «Терапевтические антитела»: «Краткая история открытия и применения антител» [30] и «Антитело: лучший способ распознать чужого» [31].
В естественных условиях после появления удачного варианта антитела в популяции B-лимфоцитов постепенно накапливаются мутации, и отбор раз за разом оставляет все более и более аффинные антитела. Брайан Хи и Питер Ким из Стэнфорда доверили это дозревание антител языковой модели ESM. Модель ничего не знала ни о мишени, ни о структуре: она просто предлагала эволюционно правдоподобные замены на карте толерантности. Взяли четыре клинически важных антивирусных антитела — среди них препарат против вируса Эбола, одобренный FDA; и против гриппа, дошедший до второй фазы. Проверив в лаборатории менее двадцати вариантов каждого, авторы подняли аффинность зрелых антител до семи раз, а их незрелых предковых версий — до 160. Многие заодно еще и стали стабильнее [32].
Не одно свойство, а связка
Но аффинность — это только полдела. От терапевтического белка требуется целый букет свойств разом: он должен быть специфичным к мишени (иначе будут побочки), стабильным при хранении (чтобы ампула не портилась на полке), растворимым и не склонным к агрегации — и при этом неиммуногенным. Беда в том, что часто, улучшив одно, ломаешь другое. Чтобы антитело крепко вцепилось в мишень, его связывающей поверхности часто нужны гидрофобные участки — но те же участки охотно липнут и к соседним молекулам, и белок начинает агрегировать. А агрегат из одинаковых частиц иммунитет принимает за что-то вирусоподобное и вырабатывает антитела уже против самого лекарства. Вакцинным наночастицам это только на пользу: так они становятся заметнее для иммунитета; но терапевтические антитела после такого перестают работать. Вдобавок современные препараты нередко колют подкожно, впихивая всю дозу в пару миллилитров, — концентрация растет, и слипнуться становится еще проще. Так что для медицины мы оптимизируем не одно свойство, а всю связку разом [33], [34].
Начнем с иммуногенности. Наши фонари подсвечивают все, что правдоподобно для эволюции вообще, — а это последовательности со всего живого мира: бактерий, вирусов, грибов. Нам же нужно, чтобы антитело выглядело своим именно для человека. Значит, и учить модель надо не на эволюции вообще, а на антителах — и так, чтобы она различала среди них человеческие.
Так устроена IgLM [35]. Ее обучали на Observed Antibody Space — базе, где каждая последовательность антитела идет с пометками: тяжелая это цепь или легкая и какому виду принадлежит [36]. Пометки дают модели лишнюю степень свободы: усвоив, чем человеческие антитела отличаются от мышиных или верблюжьих, она сможет «писать» именно человеческие. Работает IgLM не совсем как ESM: та прячет одну букву и угадывает ее по соседям, а IgLM восстанавливает сразу целый кусок — например, петлю (CDR), переписанную на человеческий лад. А поскольку модель заодно «тянет» последовательность к реалистичным антителам, переписанные петли обычно оказываются еще и покладистее по биофизике.
Но, помимо иммуногенности и аффинности, остаются еще растворимость, склонность к агрегации, способность нарабатываться в клетках, геометрия петель — и проверять тысячи кандидатов в пробирке слишком дорого. Поэтому перед мокрым экспериментом их прогоняют через набор быстрых расчетных фильтров разрабатываемости (developability), каждый из которых нацелен на свое свойство. Самый известный — TAP (Therapeutic Antibody Profiler ) [33]: что-то вроде «правила пяти» для антител, по аналогии с правилом Липински, которым отбраковывают неудачные лекарства — малые молекулы. Если у молекулы слишком крупные гидрофобные или заряженные участки на поверхности, слишком длинные петли или слишком асимметрично распределен заряд между тяжелой и легкой цепями — то антитело, скорее всего, неудачное и будет вести себя плохо.
Помимо TAP, используется еще масса других фильтров: NetMHCpan ищет в цепочке фрагменты, за которые может зацепиться иммунитет [37]; DeepSol оценивает растворимость, от которой зависит риск агрегации [38]; ABlooper проверяет геометрию петель [39]. До пробирки доходят только варианты, прошедшие все проверки. Фермент мы правим под реактор, а антитело — под человека, и потому требований к антителу много, и чтобы учесть их все, нужна целая батарея фильтров.
Germinal: антитело с чистого листа
Можно пойти и другим путем — дособрать связывающие петли вокруг готового, уже хорошо отработанного каркаса (нано)антитела. Петли должны отлично подходить к мишени и при этом все еще выглядеть как настоящее антитело. Чтобы удержать оба качества, на них одновременно давят две силы: AlphaFold помогает найти то, что хорошо связывает, а IgLM делает белки похожими на настоящие антитела (рис. 4) [40].
Когда петли готовы, несвязывающую часть дополнительно переписывают, укрепляя конструкцию, с помощью AbMPNN — антительная версия ProteinMPNN, про которую подробнее мы расскажем позже [42], [43]. Напоследок кандидатов проверяют с помощью биофизических фильтров и AlphaFold 3, про который у нас недавно вышла статья: «AlphaFold 3: как диффузионные модели пришли в предсказание структуры белков» [26]. Так с помощью Germinal собрали наноантитела против PD-L1 — тормоза, которым опухоль глушит атаку иммунитета и по которому бьют современные противораковые препараты. Сработали до 22% вариантов — а это по современным меркам очень много!
Компас: не только живые, но и рабочие белки
2-я остановка из 4 · Компас: выбираем направление.
иллюстрация автора, созданная с помощью Grok
Языковые модели расставили фонари-ориентиры в тумане последовательностей, но решают они только половину задачи: карта толерантности подсвечивает замены, которые белок переживет — которые эволюция сочла бы хорошими. Но эволюция вела белки к своим вершинам: к быстрому обороту в клетке, к точной регуляции, к экономной сборке. Самые яркие фонари ведут к «живому» белку, а не к идеальному (в том смысле, что нам надо для биотехнологии и медицины). И если сравнить ландшафты эволюционного правдоподобия и реально измеренной активности, то они очень часто не совпадают (рис. 5). И самые естественные варианты чаще всего не самые рабочие [44]. Значит, нужен прибор, который сможет среди уже жизнеспособных вариантов найти нужные именно нам.
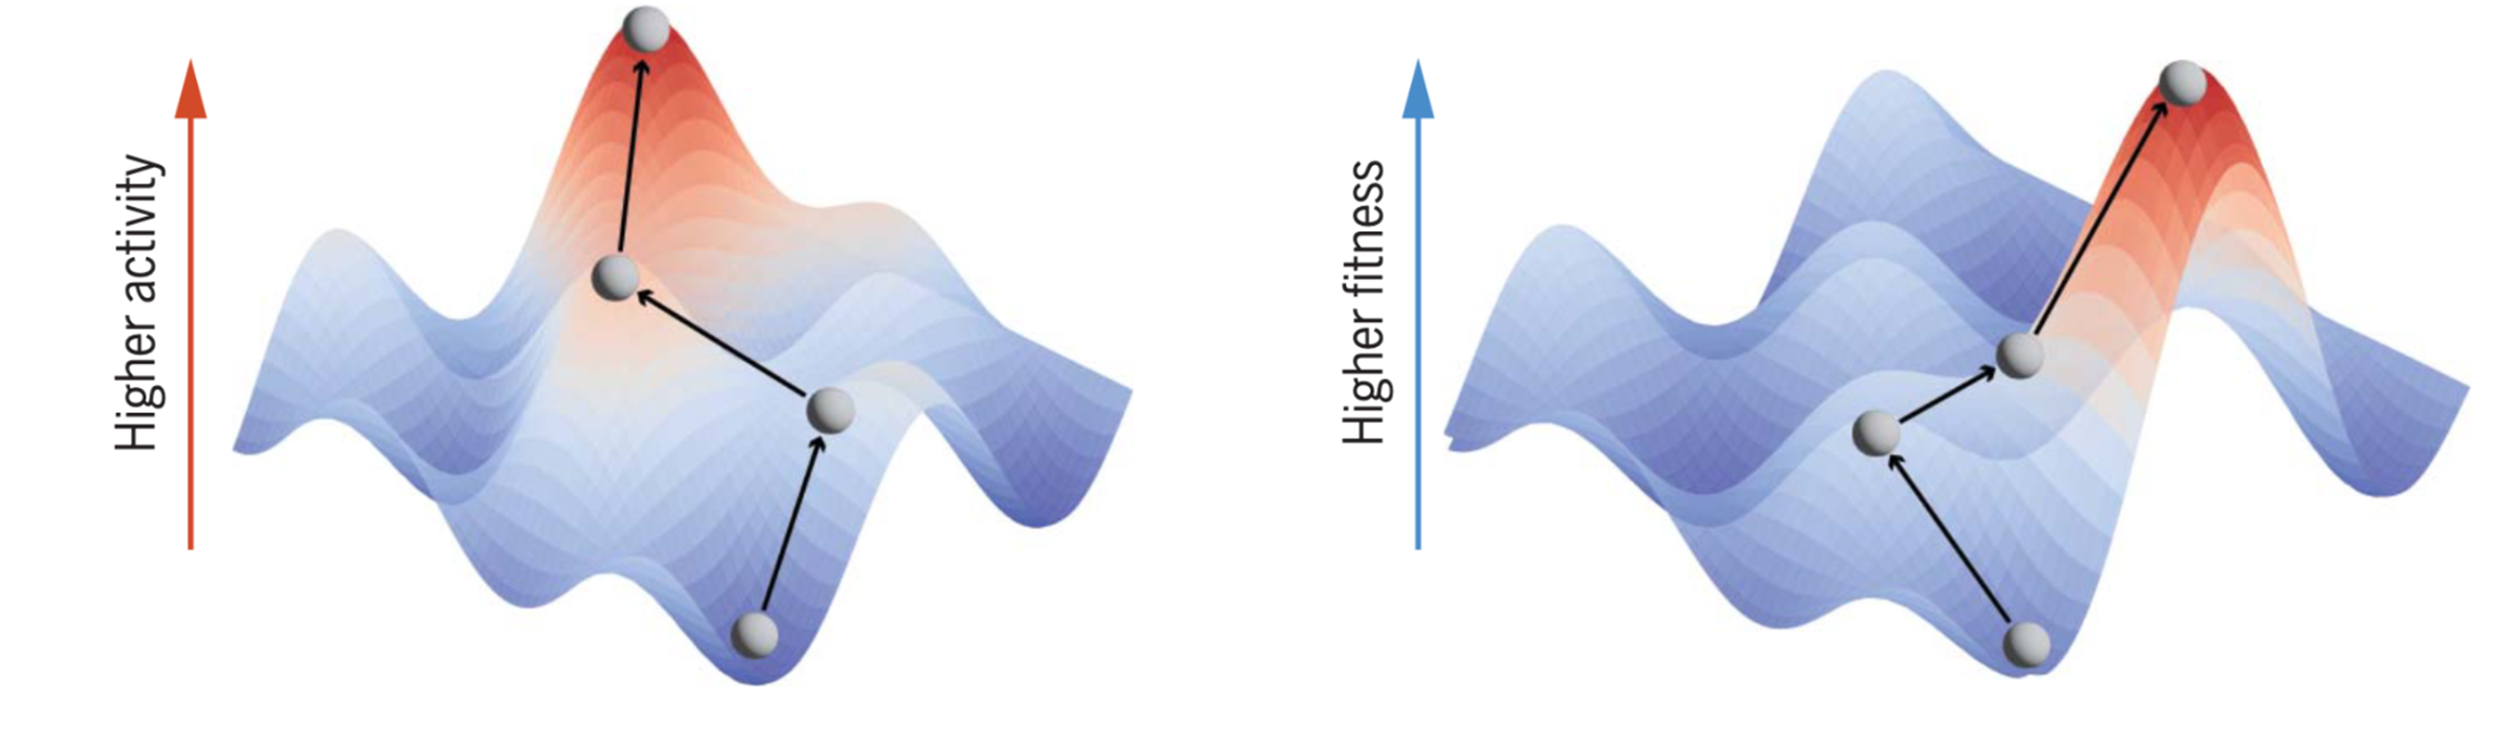
Рисунок 5. Самый правдоподобный белок и самый полезный — это не одно и то же. Справа — ландшафт эволюционного правдоподобия (что жизнеспособно), слева — ландшафт измеренной активности (что полезно именно нам).
Свернуть в эмбеддинг можно и весь белок целиком — тогда похожие белки получают похожие наборы чисел, и нам остается только научиться узнавать по ним белки с нужными свойствами. Для этого поверх языковой модели сажают вторую, крошечную модель-оценщик — например, случайный лес [25], [44]. Мы собираем несколько десятков вариантов и проводим эксперимент — да-да, в настоящей мокрой лаборатории! — меряем у каждого нужный нам параметр (например, оптимальную температуру работы, ферментативную активность или еще что-то). По этим числам и учится оценивать кандидатов маленькая модель: например, такие паттерны чисел в эмбеддинге отвечают высокой активности, а такие — низкой.
И здесь у нас появляются модные в машинном обучении слова: zero-shot и few-shot. Zero-shot — это работа программы «из коробки»: модель ранжирует замены, не видя ни одного нашего эксперимента (и различает только жизнеспособное и мертвое, не видя разницы между нашими очень конкретными белками). А few-shot — когда мы подмешиваем собственные измерения, чтобы «дообучить» модель (о чем и шла речь абзацем выше).
Важно, что есть возможность ограничиться небольшим числом экспериментов: маленькие модели достаточно быстро и легко обучаются. Достаточно около полутора десятков проверенных в лаборатории вариантов, чтобы оценщик уже мог находить некоторые закономерности в эмбеддингах [44]. С его помощью ранжируют остальные тысячи вариантов, измеряют лучшие по его мнению и снова дообучают (рис. 6). За несколько таких раундов в лаборатории проверяют менее сотни вариантов белков — вместо тысяч, как это делали в направленной эволюции. Такой подход называют направленной эволюцией под управлением машинного обучения (machine learning-guided directed evolution).
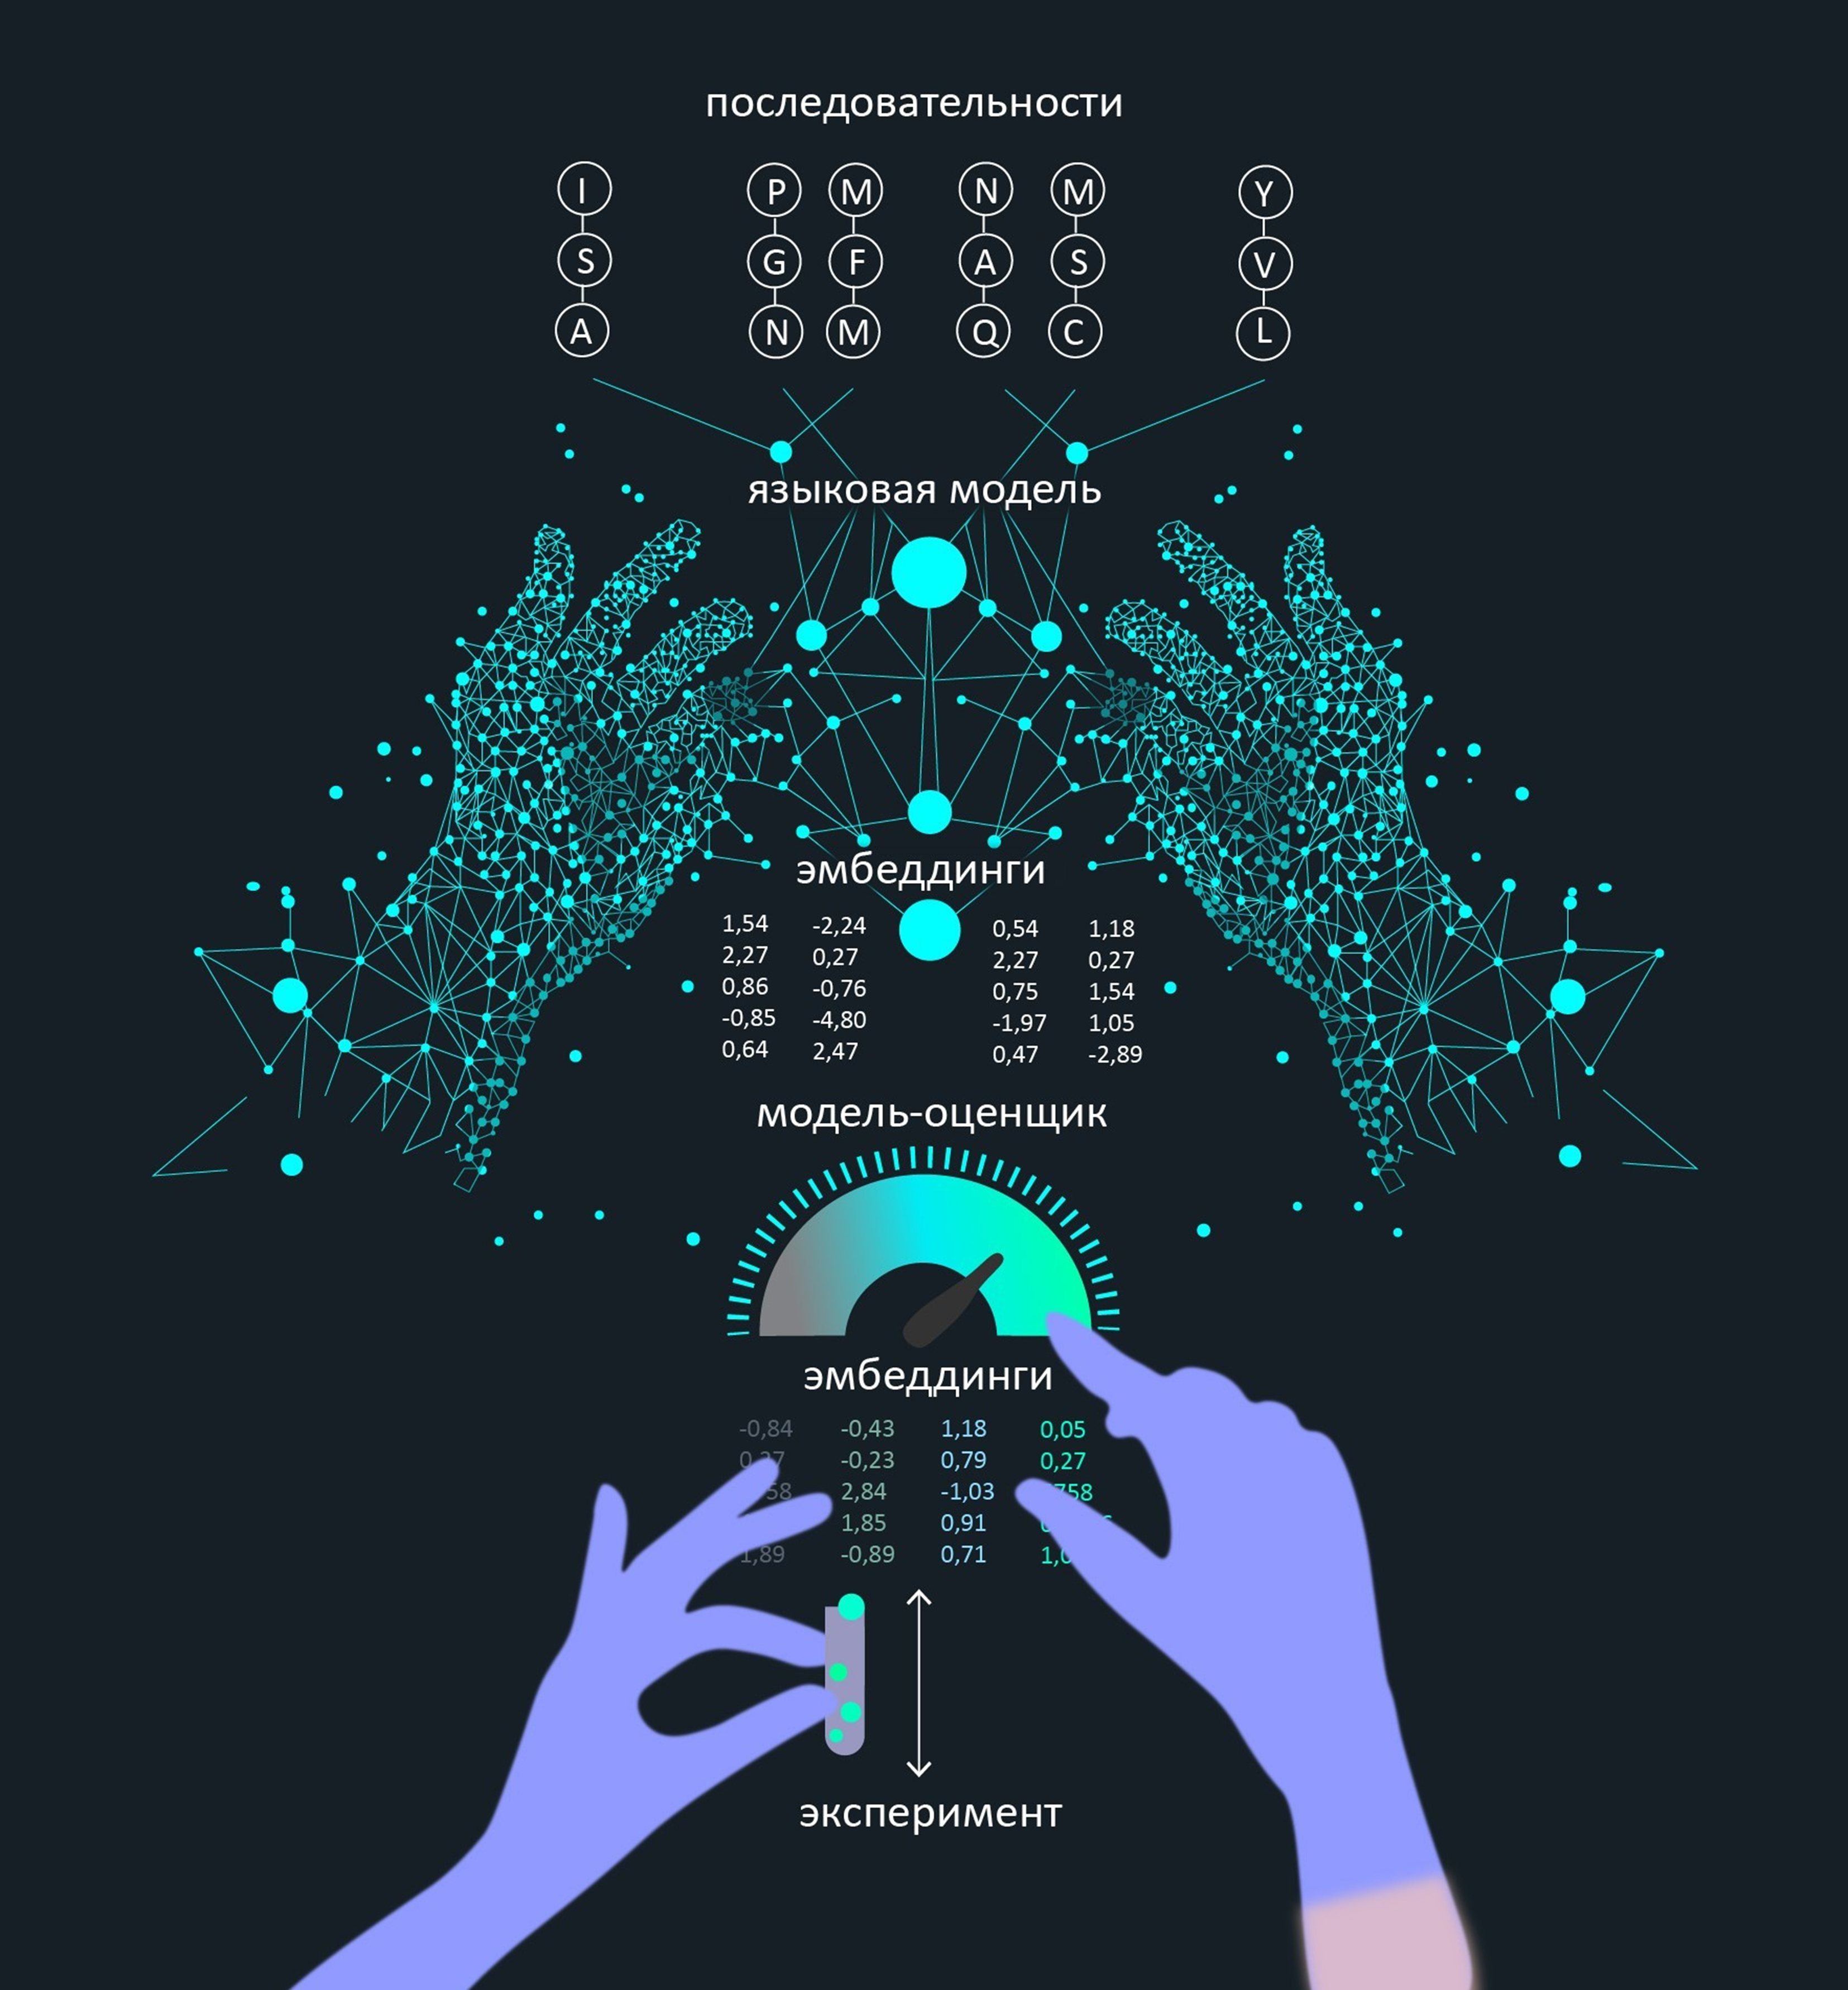
Рисунок 6. Полтора десятка замеров превращают zero-shot модель общего назначения в few-shot модель, заточенную под нашу задачу. Сверху — последовательности белков. Чуть ниже языковая модель сворачивает каждый вариант в эмбеддинг. Обученная на небольших объемах собственных данных модель-оценщик смотрит на них, узнает определенные паттерны в наборах чисел и расставляет варианты по порядку: чем ярче, тем перспективнее вариант уже по нашей мерке, а не по эволюционной. В пробирку уходят только самые яркие, а полученные замеры возвращаются обратно и дообучают оценщика — на следующем круге он ранжирует точнее. Сама языковая модель при этом не меняется — настраивается только маленькая надстройка над ней.
иллюстрация Виктории Шарманкиной
EVOLVEpro: полевой компас
По такому принципу работает EVOLVEpro [44]. Им, например, улучшили Т7-РНК-полимеразу — фермент, которым нарабатывают почти всю терапевтическую мРНК: и вакцины, и мРНК-препараты. Проблема у нее в побочном продукте. Помимо транскрипции с ДНК-матрицы, полимераза иногда попутно синтезирует короткие фрагменты РНК, используя саму РНК как матрицу. Все это сворачивается в двуцепочечную РНК, которую иммунитет принимает за вирусную. Такой мРНК-препарат вызывал воспаление, а очистка от этого мусора заметно повышала себестоимость.
Тянуть нужно было сразу за два свойства — больше работающей мРНК и меньше иммуногенной примеси. Для этого поверх эмбеддингов вешают не одного оценщика, а несколько: по одному на каждое измеряемое свойство, и ранжируют варианты по обоим свойствам сразу. К четвертому раунду нашлась одна замена, с которой наработанная полимеразой мРНК в клетках давала в 34 раза больше белка и на 98% меньше воспалительного ответа. К шестому раунду модель собрала уже комбинацию замен, повысивших выход белка с такой мРНК до 57 раз. Итоговый фермент обошел лучший на тот момент рукотворный вариант полимеразы: вдвое меньше воспаления и всемеро больше белка с той же матрицы [44].
Тем же способом подтянули еще несколько полезных для биотеха молекул: компактная CRISPR-нуклеаза, помещающаяся в вирусный вектор, стала в пять раз эффективнее редактировать геном, интеграза — в четыре раза чаще вставлять крупные конструкции, а прайм-редактор — вдвое. А у противоковидных моноклональных антител усилилось связывание с мишенью до тридцати раз [44].
PRIME: умный термометр
У few-shot есть цена: измерения приходится добывать заново под каждое новое свойство и каждый новый белок. Но одно свойство нужно почти всем и почти всегда — термостабильность: от неё зависят и срок хранения, и работа в горячем реакторе, да еще она дает запас прочности, который потом зачастую можно разменять на мутации, повышающие активность. Такое универсальное свойство имело бы смысл вшить в модель, а не настраивать каждый раз с нуля.
Но температуру плавления меряют по одному белку за раз, в разных лабораториях разными методами, и сопоставимых измерений набирается немного. Зато у каждого белка есть бесплатная косвенная характеристика: температура, при которой живет его хозяин. Она известна для десятков тысяч видов и отлично коррелирует с термостабильностью их белков — так набирается около 96 миллионов последовательностей с температурной пометкой [45]. Метка хоть и грубая (в термофильной бактерии полно белков средней прочности), но на таком объеме статистика берет свое.
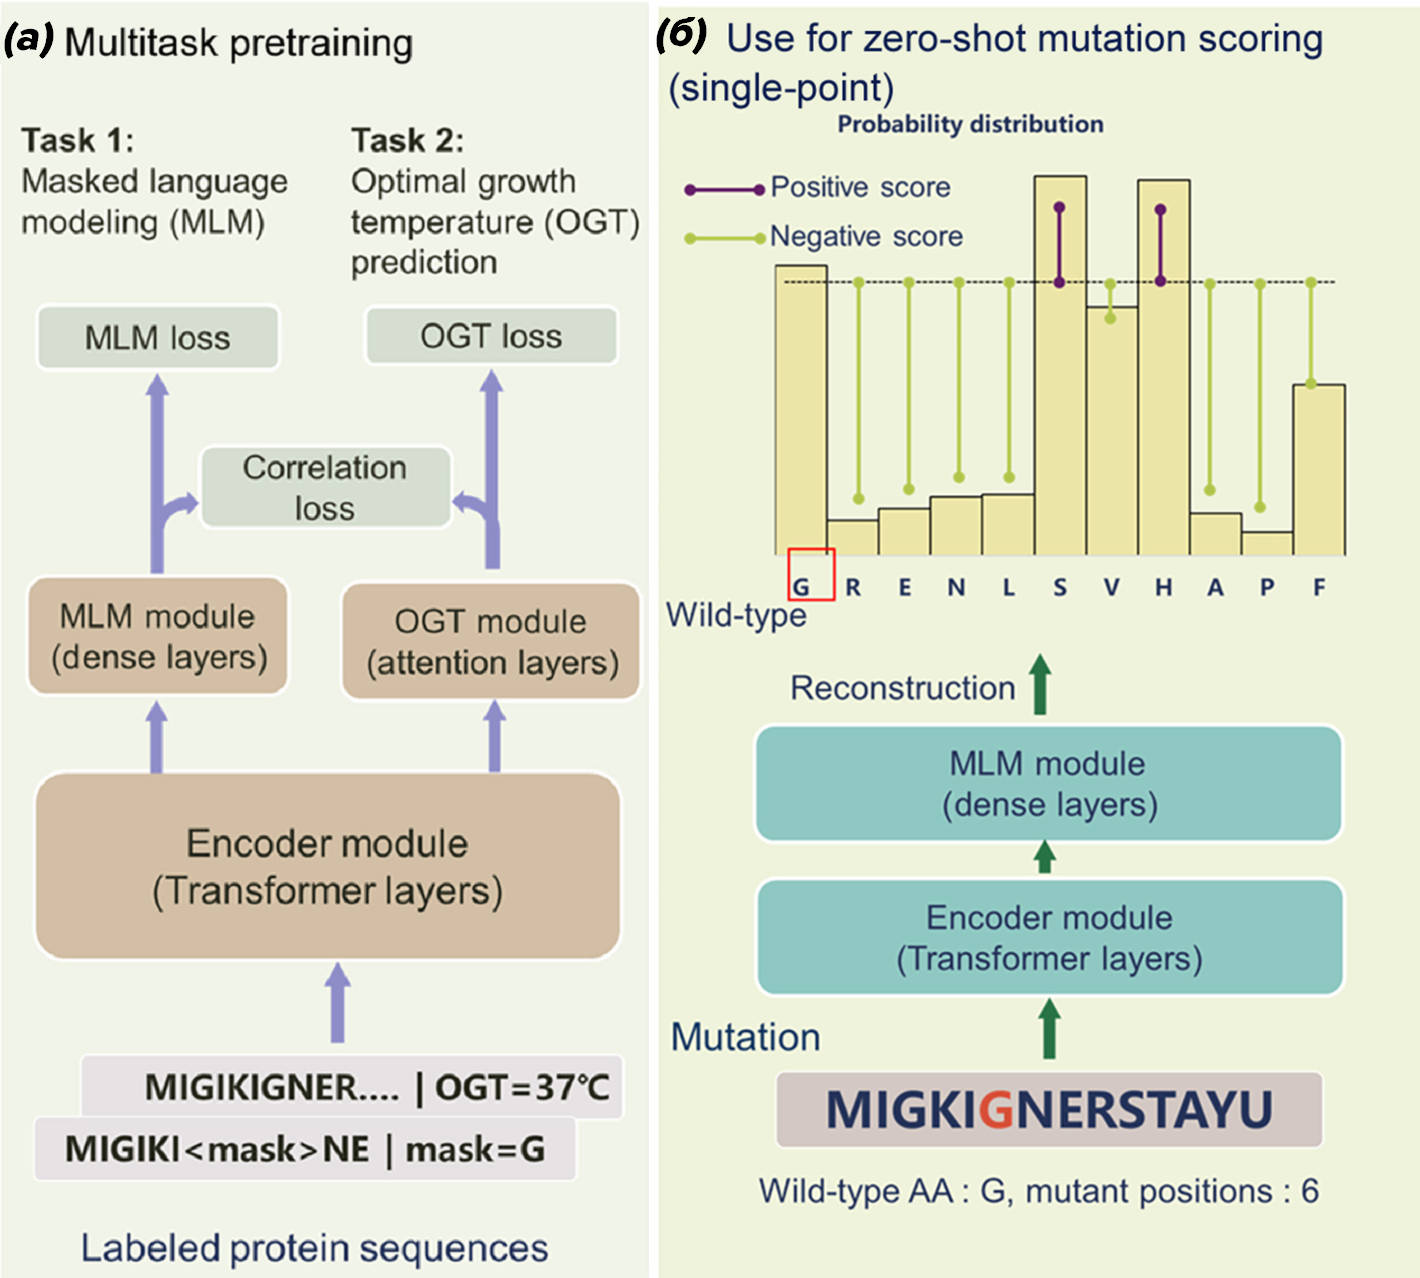
Рисунок 7. PRIME: языковая модель со встроенным термометром. (а): модель учится параллельно двум задачам: угадать замаскированную аминокислоту и предсказать температуру, при которой живет организм-хозяин. (б): из-за этого карта толерантности сразу подкрашена «на прочность»: аминокислоты, набравшие больше баллов (фиолетовая линия) — здесь S и H обошли G — скорее всего сделают белок стабильнее.
Так устроена PRIME [45]. Ее учат сразу двум вещам: угадывать недостающую аминокислоту, как в ESM; и параллельно называть температуру, при которой жил хозяин. На выходе получаются две оценки для каждой возможной замены — насколько она правдоподобна с точки зрения эволюции и насколько похожа на то, что стоит в этой позиции у термофильных белков (рис. 7). Более 30% предложенных ею замен действительно повышают стабильность, что достаточно много. Двенадцати замен хватило, чтобы поднять термостабильность уже знакомой нам Т7-полимеразы на 12,8 oC, и восьми — чтобы прибавить 6,25 oC нуклеазе LbCas12a [45].
Но если нужно свойство, которого термометр не покрывает, никто не мешает вернуться в режим few-shot и настроить оценщика под собственные замеры — именно так и сделали, когда понадобилось антитело, устойчивое к щелочи.
Многие рекомбинантные белки на производстве чистят аффинной хроматографией: в колонке сидит сорбент с пришитым антителом, которое вылавливает целевой белок из культуральной жидкости. Чтобы на колонке не накапливались микроорганизмы, ее промывают раствором щелочи. Но природное антитело такой стирки не выдержит: примерно после 60 циклов сорбент выдыхается, и его меняют, а стоит он дорого. Сначала PRIME без единого эксперимента отранжировал все одиночные замены наноантитела, лучшие проверили в лаборатории. Модель дообучили, и среди еще десятков предложенных мутантов нашли лучший, который держал более 140 циклов очистки без падения выхода, а попутно стал термостабильнее и крепче связывал мишень. Его уже используют в производственных реакторах на тысячи литров, а экономия оценивается более чем в миллион долларов в год [46].
MODIFY: разнообразный старт
И внешний компас, и встроенный термометр двигают нас одинаково: меняя по одной букве — мы все время кружим вокруг стартовой последовательности и получаем набор почти одинаковых ее двойников. И если исходный белок оказался тупиковым, то сколько его ни улучшай — все потомки скорее всего будут провальными. Поэтому, чтобы не проверять в лаборатории сотни двойников, начинать лучше не с одного белка, а набора разнообразных вариантов.
Собрать такой набор, выделив максимально непохожие последовательности, не получится — почти все окажутся нежизнеспособны или вовсе станут больше похожи на какой-то другой белок.
Нужен компромисс — уйти от исходника как можно дальше, но ровно настолько, чтобы белок остался максимально рабочим. Этим и занимается MODIFY: он оценивает варианты и ищет наилучший размен между правдоподобием и разнообразием — так называемую границу Парето. И на выходе получается разнообразная, но все еще жизнеспособная стартовая библиотека [47]. Вдобавок разнообразием можно управлять по отдельным позициям: если известно, что какой-то участок очень важен — его фиксируют (рис. 8).
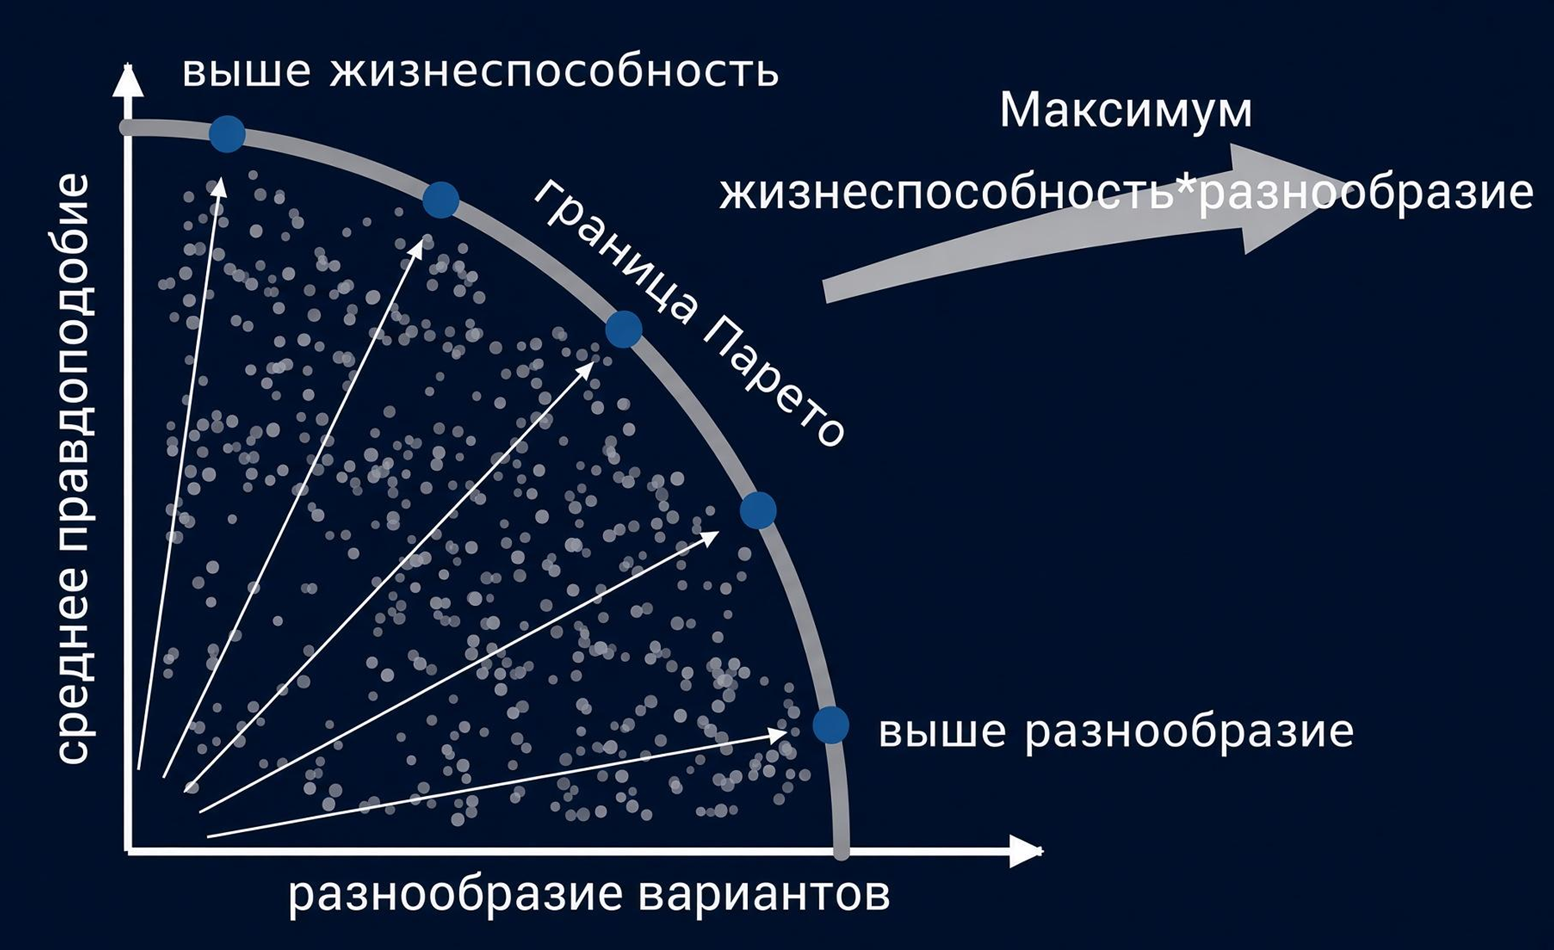
Рисунок 8. MODIFY: за жизнеспособность библиотеки платят разнообразием, и наоборот. Каждая серая точка — отдельная библиотека вариантов. По горизонтали — насколько ее последовательности непохожи друг на друга и на исходный белок. По вертикали — среднее правдоподобие и жизнеспособность вариантов в библиотеке. Улучшить обе величины разом нельзя: чем дальше библиотека уходит от исходника, тем больше в ней нерабочих вариантов. Серая дуга — граница Парето, набор наилучших компромиссов: все, что лежит под ней, хуже хотя бы по одному признаку. Рабочую библиотеку выбирают прямо на дуге (синие точки), сдвигаясь по ней в зависимости от того, чего не хватает — разнообразия или жизнеспособности вариантов.
адаптировано на основе [47]
Проверяли такой подход на уже знакомом нам цитохроме c. MODIFY взял дикий цитохром и, отобрав около 160 вариантов за один проход, выдал целую библиотеку рабочих катализаторов и для кремниевой, и для родственной ей углерод-борной реакции, на которой держится синтез противоопухолевого препарата бортезомиба. Лучшие варианты отличались от добытых в пробирке всего шестью заменами, работали примерно вдвое активнее, а один и вовсе неплохо катализировал обе реакции сразу, что для таких ферментов редкость [47].
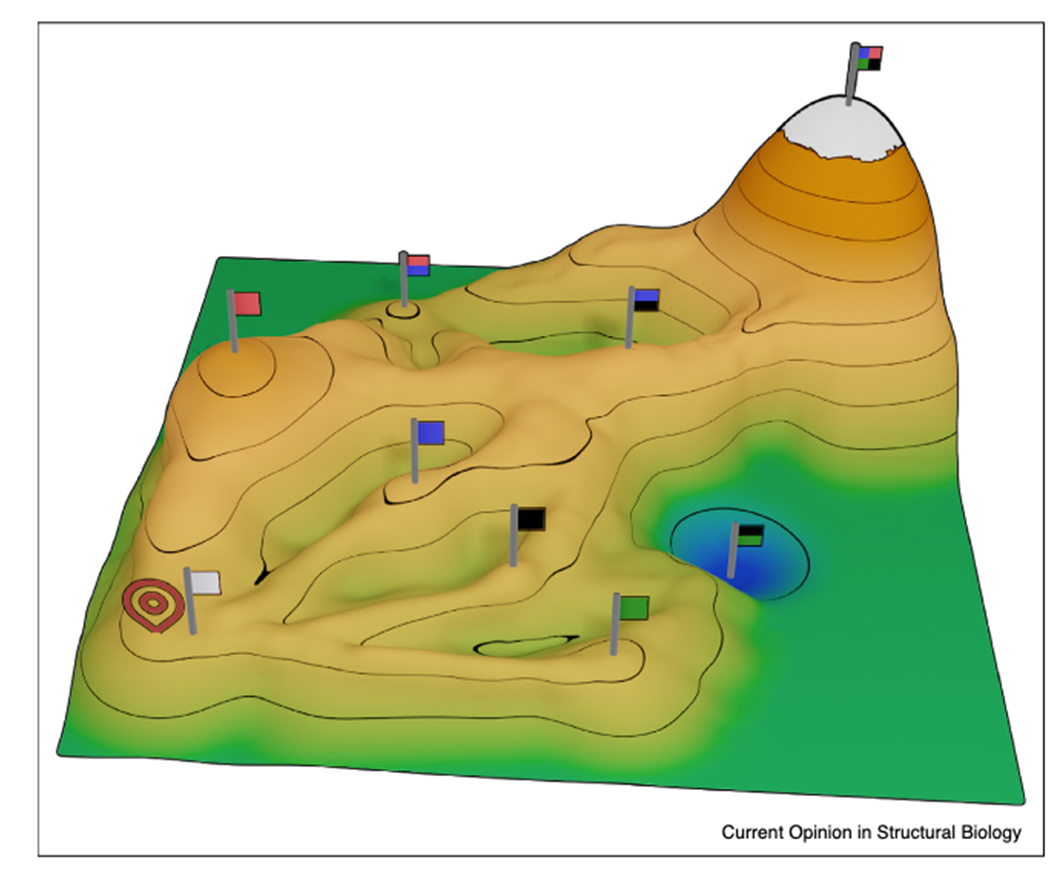
Рисунок 9. К лучшему варианту ведет дорога через худшие. Каждый цвет флажка — это одна мутация. По отдельности мутации могут никак не влиять на белок, а иногда и ухудшать его — пошаговый отбор их отбрасывает. Дорога к лучшему флажку из четырех мутаций (вершина) идет через варианты хуже стартового, поэтому пошаговым улучшением до него не добраться.
Компас помог нам лучше выбирать направление движения, а разнообразный старт позволил не застревать в окрестностях неудачных последовательностей. Но двигаемся мы по-прежнему по одной замене, а белок держится на сети взаимодействий между десятками аминокислот — и почти любая случайная мутация рвет больше контактов, чем создает.
Пока в белке остаются замены, добавляющие новые более сильные контакты, пошаговый отбор их находит. Но когда они кончаются, остается только пересобирать старые контакты, меняя аминокислоты согласованно парами, тройками или даже целыми ансамблями из нескольких остатков (эпистаз). Поодиночке, без напарника, такие мутации будут ничем не лучше случайной замены, которая ничего не улучшает, а чаще делает белок хуже — и такой шаг отбраковывается и в пробирке при направленной эволюции, и любой моделью (рис. 9) [48].
Карта семейства: прогулка по латентному пространству
3-я остановка из 4 · Карта: путешествие по белковой вселенной.
иллюстрация автора, созданная с помощью Grok
До сих пор модель работала советчиком: буквы меняли мы, а она оценивала, что из этого выйдет, — мы прогоняли собственные замены через ее представление о белках, как через сито. Но в это представление можно залезть и напрямую: искать подходящий белок прямо среди эмбеддингов, а найденный набор чисел разворачивать обратно в последовательность. Тогда перебирать буквы не придется вовсе, и эпистаз перестанет быть препятствием — один шаг по такому пространству приведет к другому белку сразу со множеством замен, согласованных между собой.
Этим и занимается автокодировщик — пара сетей, которые учатся вместе. Энкодер сжимает последовательность в короткий вектор, а декодер по этому вектору собирает последовательность обратно (рис. 10). Все возможные значения этого вектора и образуют латентное пространство семейства: каждый белок в нем — точка, а ее координаты — числа из эмбеддинга: чем их больше, тем больше у пространства измерений.
Каждое измерение хранит по кусочку информации о белке, а их сочетания — уже закономерности. Чем измерений больше, тем лучше мы можем описать белок. У ESM2 (в редакции 650M параметров), например, на каждую аминокислоту приходится эмбеддинг размером 1280 чисел, а на весь белок набегает под полмиллиона. У автокодировщика на весь белок отводится всего несколько десятков чисел [49], [50]. В точности восстановить из такого маленького вектора цепочку в сотни аминокислот невозможно, а декодер штрафуют за каждую перепутанную букву. Деваться некуда, и через такое бутылочное горлышко проходит только самое важное для работы белка — то, что повторялось у всех его родственников: как уложена цепь, где стоит активный центр, какие позиции меняются согласованно. Вариабельная поверхность и петли у каждого гомолога свои — размерности латента на конкретные аминокислоты не хватит, а потому декодер достроит их сам по правилам семейства, на котором энкодер с декодером учились вместе (рис. 10).
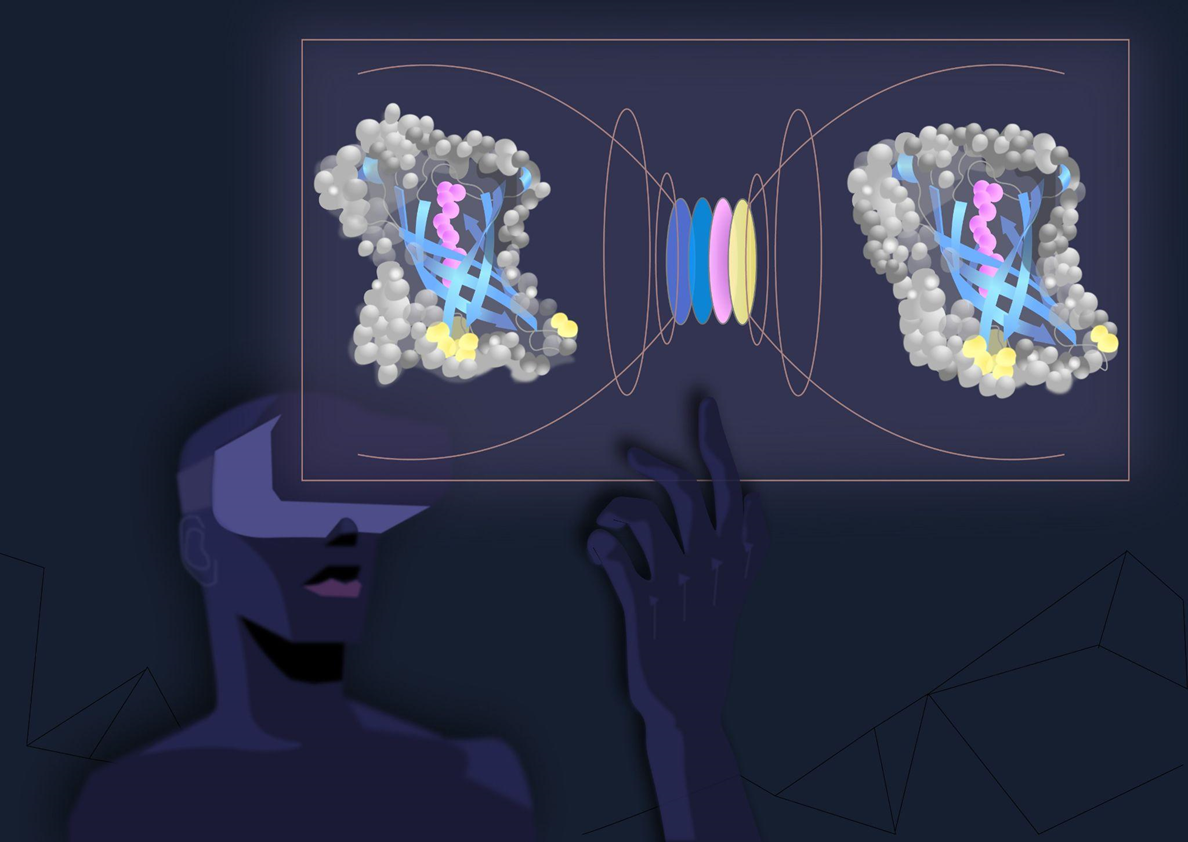
Рисунок 10. Через бутылочное горлышко латентного пространства проходит устройство белка, а не его буквы. Энкодер (воронка слева) сжимает последовательность в короткий вектор-эмбеддинг — цветные диски в горлышке между воронками. Места в векторе мало, поэтому в него помещаются только признаки, общие для всего семейства: те, на которых держится устройство и работа белка. Декодер (воронка справа) разворачивает вектор обратно в последовательность. (Для красоты последовательности тут изображены 3D-структурами.) Цветные участки — то, что поместилось в вектор и протиснулось через бутылочное горлышко. Серое — вариабельные области, которые декодер достраивает сам.
иллюстрация Виктории Шарманкиной
Информация спрессована так плотно, что распаковывается только целиком — в готовый белок. Поэтому и координаты белка получаются привязаны не к последовательности, а к его устройству [51]. Соседние точки — это белки, похожие по устройству и функции, но при этом по последовательности они могут расходиться на десятки позиций (рис. 11).
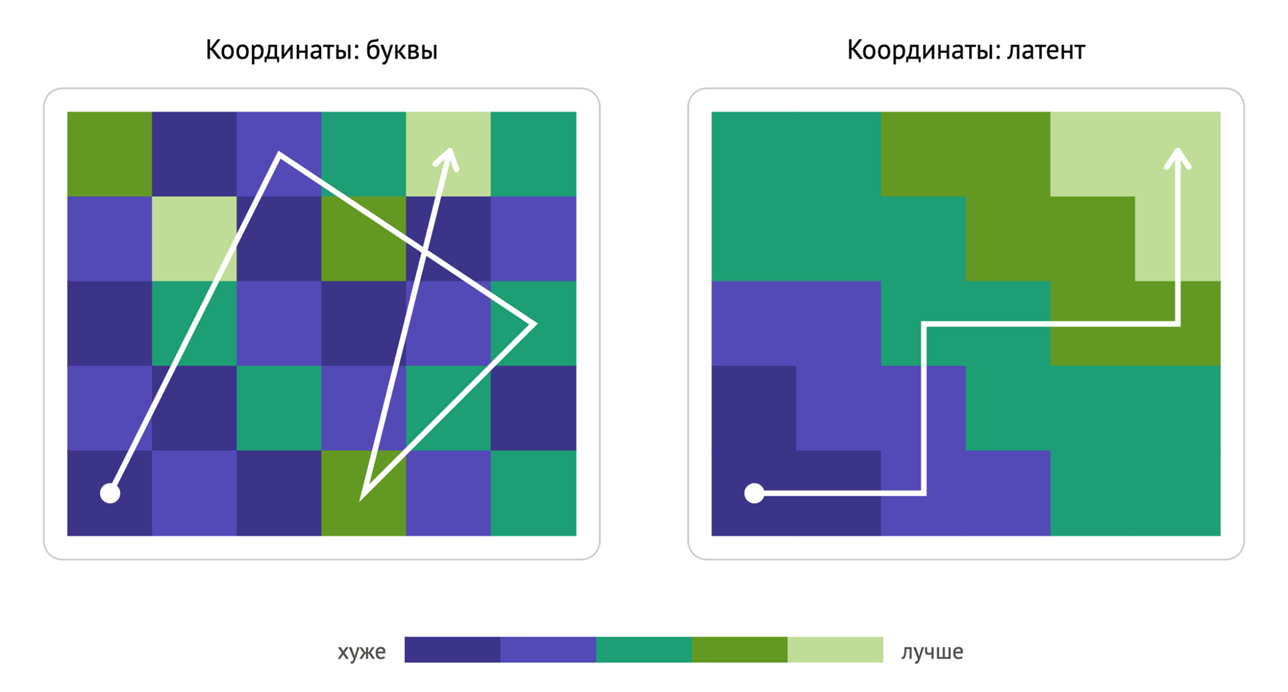
Рисунок 11. Одни и те же белки: слева разложены по буквам, справа — по эмбеддингам. Каждая клетка — вариант белка: от плохого к хорошему (по какому-то нашему критерию). Слева варианты разложены по последовательностям: соседние клетки отличаются на одну букву. В каком направлении двигаться — непонятно: соседство здесь ничего не обещает и, чтобы выловить хорошие, приходится пробовать разные мутации, ориентируясь на оценку правдоподобия модели. Справа — те же самые белки разложены по координатам латентного пространства: рядом оказываются близкие наборы чисел, то есть белки, похожие по устройству. Чуть изменишь координаты — белок похожий, но уже может отличаться на десятки позиций.
иллюстрация автора, созданная с помощью Claude
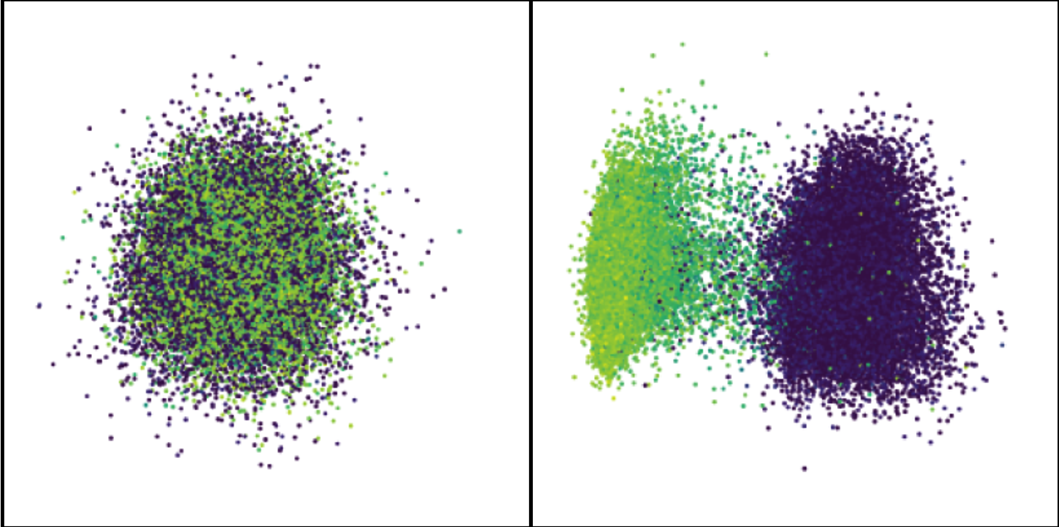
Рисунок 12. Штраф превращает россыпь точек в карту, по которой можно двигаться. Каждая точка — вариант зеленого флуоресцентного белка GFP: фиолетовые светятся слабо, желтые и зеленые — ярко. Слева — латентное поле обычного автокодировщика: яркие и тусклые варианты перемешаны, и соседство точек ни о чем не говорит. Справа — оно же, после введения штрафа: варианты разошлись по яркости, и теперь соседство стало осмысленным: шагнув от яркой точки, скорее всего попадешь тоже в яркую. Латентное пространство многомерно, поэтому любая его картинка — плоская двумерная тень (UMAP или PCA), и расстояния на ней передают соседство лишь приблизительно.
Правда, у обычного автокодировщика есть проблема: точки оказываются разбросаны как попало, и между ними остаются пустоты, куда при обучении не попала ни одна реальная последовательность. Достать оттуда белок не выйдет: таких координат декодер не видел и выдаст по ним бессмыслицу. Пространство вроде бы и есть, но гарантированно рабочие точки в нем — только те, которые модель уже видела. Нам же нужно, чтобы работали и промежутки: чтобы белок собирался по тем же правилам не только в известных точках, но и между ними.
Чтобы пустот не оставалось, автокодировщик делают вариационным (VAE): энкодер выдает не отдельную точку, а небольшое облачко вокруг нее, а специальный штраф не дает этим облачкам разбегаться по пространству (см. врезку ниже). Точки стягиваются в плотное поле без прорех — и координат, на которых декодер теряется, в нем практически не остается (рис. 12). По такому полю уже можно прогуляться — меняя свои координаты (числа в эмбеддинге), мы будем попадать в точки, из которых декодер способен доставать рабочий белок.
Раньше мы выбирали букву, оглядываясь на то, насколько такая замена привычна модели. Теперь оглядываться не нужно: на этой карте привычны все точки, и вопрос только в том, куда с нее шагнуть. Шаг дает другой рабочий белок того же семейства — с той же функцией, но отличающийся сразу десятком-другим согласованно подобранных замен (рис. 12). А интерполируя между двумя реальными белками, можно получить их гибрид, который эволюция еще не пробовала.
На этом и построили поиск новых вариантов бактериальной люциферазы. Ее, как и GFP, видно прямо в живой культуре, и по свечению сразу понятно, включен нужный ген или нет. Этим пользуются, например, в экологическом мониторинге: ген ставят под нужный промотор, и культура вспыхивает или, наоборот, гаснет в ответ на тяжелые металлы, повреждения ДНК или окислительный стресс. Такие датчики стоят на станциях проточного контроля воды, и от яркости фермента и того, насколько хорошо он нарабатывается, зависит и чувствительность прибора, и его цена.
VAE обучили примерно на 70 тысячах последовательностей люцифераза-подобных оксидоредуктаз, нашли точку, в которую попадает проблемная субъединица люциферазы luxA, несущая активный центр, и стали искать ее варианты. Сама по себе luxA плохо растворима и охотно уходит в осадок без второй субъединицы luxB, которая как подпорка не дает ей развернуться. Из 46 сгенерированных моделью вариантов светились 38. Каждый такой вариант — это сразу десятки согласованных замен, а самый далекий отличался на 35 позиций от ближайшей последовательности обучающей выборки [49].
Латентное пространство при этом можно разметить: например, если при обучении подавать модели вместе с последовательностью еще и ее растворимость, то от декодера потом можно требовать не просто рабочий белок, а рабочий белок с заданной растворимостью. Для luxA это было больным местом, так что просили именно ее. Так получили еще 23 варианта luxA, и светились все 23 [49].
EVE: карта, прочитанная наоборот
Ту же карту латентного пространства можно читать в обратную сторону: не доставать из нее новые белки, а проверять чужие. Проверять, насколько замена типична для родственников этого белка и не нарушила ли она правило, которое соблюдалось сотни миллионов лет, а значит, зачем-то было нужно для выживания. Например, чтобы выяснить, какая из мутаций сломала белок и привела к болезни.
Клиническая генетика постоянно сталкивается с таким вопросом. Секвенирование находит у пациента замену в гене, связанном с болезнью, — и про саму замену чаще всего неизвестно ничего. Раньше все редкие мутации (<1%) считали вредными, но редкая замена вполне может быть безобидной, а частая — наоборот, вредной. Поэтому сегодня частота — лишь один из многих критериев патогенности. Вот только собрать эти критерии бывает не из чего. И большинство вариантов в таких генах попадают в заключение со знаком вопроса [50]. Врачу такая строчка мало что говорит, а решение принимать надо.
EVE — это набор маленьких VAE, каждый из которых обучен на своем белковом семействе. Модель оценивает, насколько типична мутация для этой группы родственных белков; таким образом с ее помощью оценили около 36 миллионов вариантов в трех с лишним тысячах генов болезней и дали основания развести по классам более 256 тысяч ранее неопределенных мутаций [50].
ProteinNPT: фильтр перед пробиркой
Языковые модели и латентное поле дали нам десятки новых кандидатов, но точность у них все еще далека от идеальной, а потому мы все равно проверяем наши редизайны в пробирке. Постепенно у нас накапливается небольшой лабораторный журнал: проверенные варианты и их измеренные свойства. Каждая его строка стоила нам денег и времени, да и кандидатов все равно больше, чем позволяет бюджет. Поэтому выжимать из журнала хочется все до последней капли — например, по проверенной горстке вариантов предсказать свойства остальных и отправить в лабораторию только самые перспективные.
Пока что при помощи маленькой модели поверх эмбеддингов мы оценивали каждый белок отдельно, поодиночке, будто учитывать больше нечего. ProteinNPT устроен иначе: он работает не с одним кандидатом, а сразу со всем журналом. Строка в журнале — это последовательность плюс ее измеренные свойства. Получается таблица, по которой учат модель почти как языковую, только пропуски она угадывает не в строчке, а по всей таблице: прячут часть аминокислот и часть измеренных значений и заставляют восстановить и то, и другое. Внимание при этом идет в двух направлениях.
Вдоль строки — как в обычной языковой модели, только к последовательности теперь пришиты столбцы свойств, и модель связывает измеренные значения с конкретными позициями — а не с эмбеддингом, как это делал оценщик. В эмбеддинге информация о всем белке усредняется, а вклад отдельных позиций размывается. По столбцу — модель смотрит, что стояло в этой позиции у остальных вариантов и как это сказалось на их свойствах. И если убрать внимание по столбцам, качество заметно упадет (рис. 14) [53].
Оценщик делал выводы по тому, что успел выучить и запомнить в весах, и, по сути, видел каждого отдельного кандидата в вакууме. В весах же ProteinNPT хранится скорее способ сравнить измеренных соседей, чем память о том, что модель видела раньше [53]. Отсюда и его название — непараметрический трансформер (Non-Parametric Transformer).
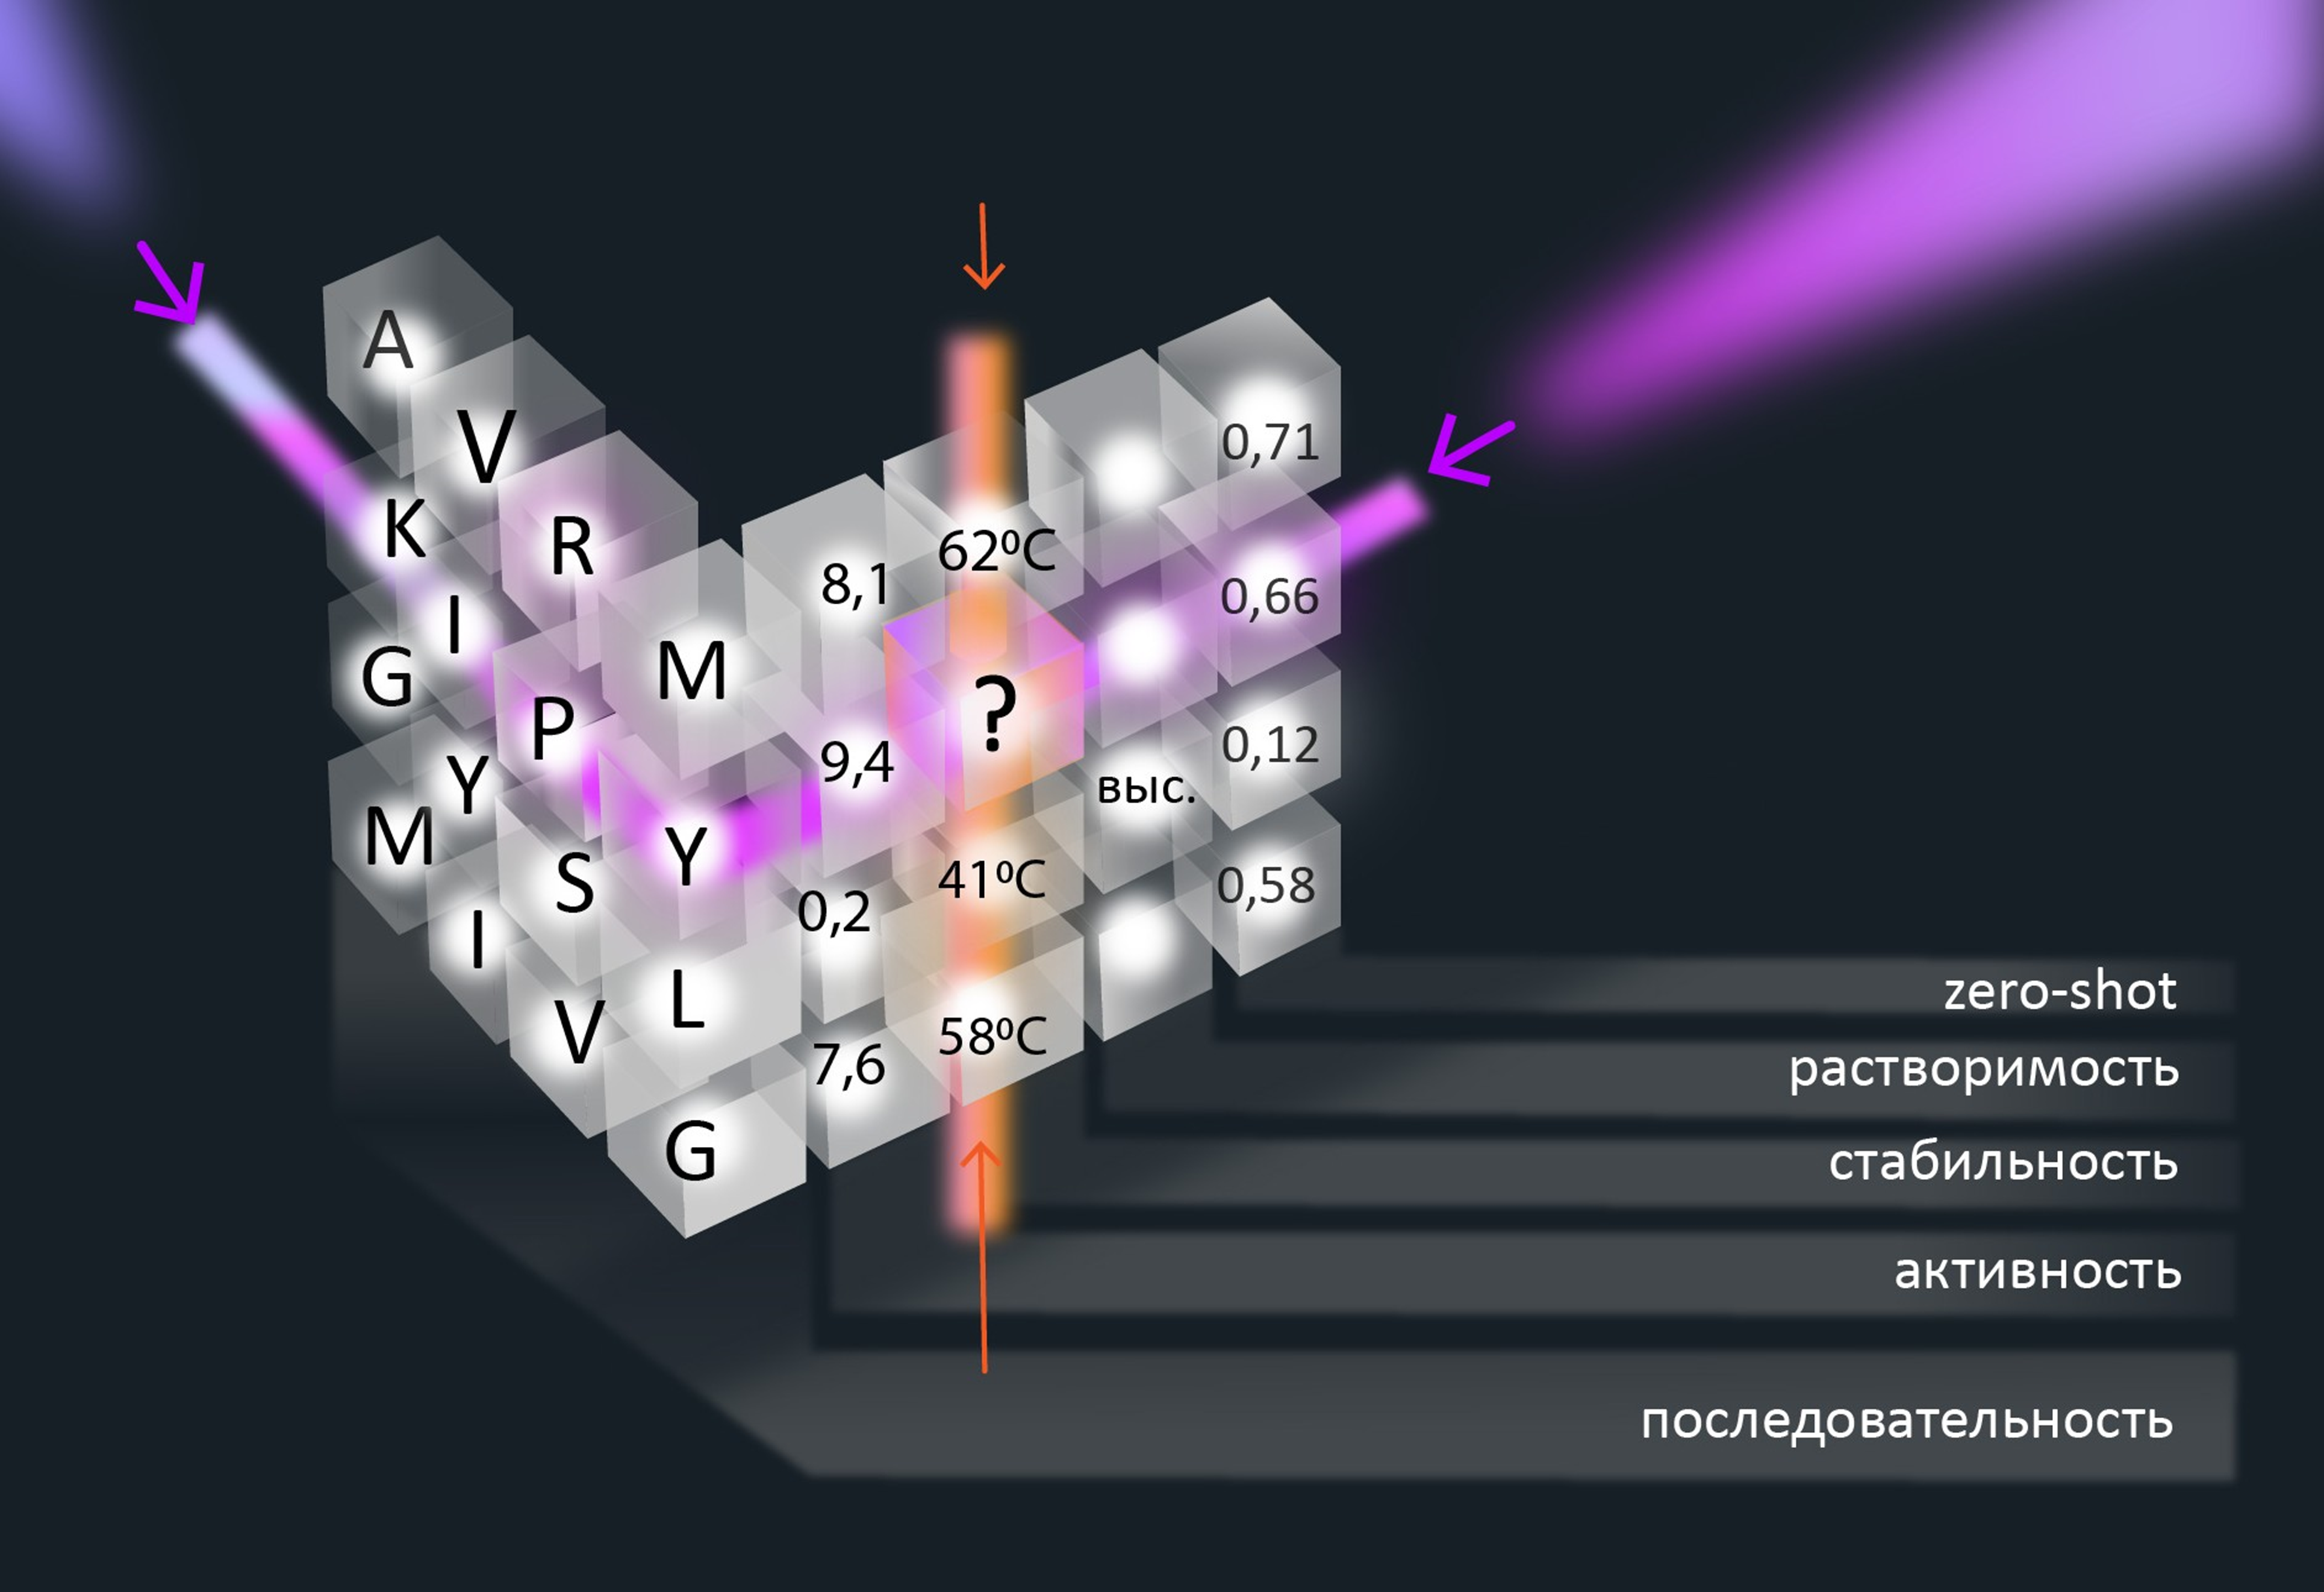
Рисунок 14. Перекличка по журналу: сравниваем соседей. Каждая строка — проверенный вариант белка, столбцы — последовательности + измеренные у них свойства (активность, стабильность, растворимость и zero-shot оценка — показаны уголком). Заполнен журнал как придется, и часть клеток пустует. Такую таблицу модель читает в двух направлениях — их подсвечивают два прожектора. Внимание по строке работает как в обычных языковых моделях, где каждая аминокислота смотрит на соседей по цепи, только теперь свойство привязано к своей последовательности и, как следствие, к конкретным позициям. Внимание по столбцу: каждая аминокислота сравнивается со своими альтернативами у других вариантов, а каждое свойство — с тем же свойством у соседей по таблице. По итогу те самые конкретные позиции оказываются связаны и со свойствами своего варианта, и с тем, что стоит на их месте у соседей по журналу: теперь варианты можно сравнивать не целиком, а по позициям.
иллюстрация Виктории Шарманкиной
Полноценной лабораторной кампании, как у EVOLVEpro или PRIME, у ProteinNPT пока нет: его проверяли на бенчмарке ProteinGym — сборнике экспериментов, где для миллионов вариантов измеряли активность, стабильность или связывание (deep mutational scanning, DMS) [54]. Благодаря тому, что правильные ответы уже известны, редизайн можно разыграть как по нотам: модель стартует, ничего не зная, выбирает варианты, тут же получает их измеренные свойства и идет на следующий круг. В этих условиях ProteinNPT обошел ту самую модель поверх эмбеддингов, вылавливая за то же число раундов заметно больше активных вариантов, — а значит, и лабораторных циклов на ту же цель уходит меньше [53]. Держится он и на вариантах сразу с несколькими заменами.
Пространство форм: чертеж белка
4-я остановка из 4 · Пространственный чертеж: совершенствуем укладку белка.
иллюстрация автора, созданная с помощью Grok
На этом дорога по буквам заканчивается. Все инструменты, которые вели нас по ней, читали один и тот же эволюционный архив — и он был для них не подсказкой, а системой координат: правдоподобие считается относительно того, что уже встречалось; разнообразие библиотеки MODIFY меряется расстоянием от исходной последовательности; латентное поле нарисовано по природным гомологам, и точка за его краем декодируется в бессмыслицу не потому, что такой белок плох, а потому, что модель там ничего не видела. Уйти этими способами далеко от того, что уже пробовала эволюция, не выходит.
Но есть и второй взгляд на белок, который на практике востребован даже больше, — геометрия: форма кармана под субстрат; поверхность, которой белок ложится на мишень; длина петли над активным центром. Языковая модель знает про нее только косвенно — она видит, что две позиции меняются согласованно, и заключает, что между ними есть связь. Но она не видит, что в свернутой молекуле они лежат в полутора нанометрах друг от друга.
А ведь бóльшую часть работы делает именно форма — и ее мы, как правило, знаем. Предсказывать ее умеет AlphaFold — нейросеть, которая по последовательности рассчитывает, как белок свернется [26] — это прямой фолдинг [5]. Обратная задача — по заданной форме подобрать последовательность, которая в нее свернется, — называется обратным фолдингом. Самая известная модель, реализующая эту задачу, — ProteinMPNN [43].
На вход она получает только остов белка — цепочку из атомов N, Cα, C без боковых групп: своего рода пространственный чертеж белка, как если бы вся молекула была собрана из глицина (единственной аминокислоты без боковой группы). Этот остов представляют в виде графа, где каждый остаток — узел, в котором записаны расстояния и углы до ближайших соседей. Узлы обмениваются этой информацией — каждый остаток как бы опрашивает соседей, кто где сидит. По их ответам в узле складывается распределение вероятностей по двадцати аминокислотам — знакомая нам карта толерантности, только выведенная не из соседей по строке, а из соседей по трехмерному пространству. Дальше последовательность собирается по одной букве, как у языковых моделей: из наиболее вероятных выбирается одна, а следующая позиция предсказывается с оглядкой на уже выбранное [43].
Позиции при этом заполняются не слева направо, а в случайном порядке: каждый раз с разных остатков, и иногда модель может выбрать не самую вероятную аминокислоту [43] — так из одной и той же формы получаются сотни разных последовательностей. И действительно, структура консервативнее последовательности: в одну и ту же структуру сворачиваются цепочки, совпадающие едва ли на треть [55]. Миоглобин кашалота, β-цепь человеческого гемоглобина и леггемоглобин из корней бобовых, которым красят и «кровят» растительное мясо, — совпадают по последовательности примерно на четверть, а укладка у всех троих одна: восемь спиралей, обернутых вокруг гема.
Родилась ProteinMPNN в дизайне de novo — там, где остов рисуют с нуля и подбирать к нему последовательность больше неоткуда. Но та же самая идея работает и с уже существующими каркасами — если подать структуру природного белка, получится редизайн. Тем более, что программа гибкая: часть остатков можно оставить «как есть», редизайня лишь часть.
Первым делом ею переписали неудачные конструкции, которые не удавалось оживить с последовательностями от «галлюцинаций» AlphaFold [41]. Так пересобрали интерфейс между субъединицами тетраэдрической наночастицы, после чего она стала собираться с высоким выходом, а кристаллическая структура почти идеально совпала с задуманной [43]. Такие самособирающиеся наночастицы используют как платформу для вакцин: на поверхность выставляют десятки копий антигена, и иммунитет реагирует на такую конструкцию гораздо сильнее, чем на отдельный растворенный белок.
Но для редизайна важнее другое: последовательности, переписанные ProteinMPNN, лучше сворачиваются в нужную структуру, чем природные [43]. Звучит странно, но причина все в той же маргинальной стабильности: эволюция держала белок у порога прочности, а ProteinMPNN обучали восстанавливать укладку, а не эволюционное правдоподобие — выбирать то, что удержит форму, а не повторит выбор эволюции.
Как сохранить функцию
Вот только модель по-прежнему не знает, зачем этот белок нужен: ее задача — сохранить форму, а не функцию. Поэтому, если мы хотим улучшить фермент, активный центр приходится отдать модели готовым, с уже проставленными аминокислотами, и заполнять только остальной остов. Так сделали с TEV-протеазой — ферментом из вируса гравировки табака. Им в биотехе отрезают от белков метки, за которые те вылавливают из клеточного лизата. Практически любой рекомбинантный белок нарабатывают с такой меткой. Однако при комнатной температуре фермент теряет активность за считанные часы, режет медленно, да еще и нарабатывается в мизерных количествах.
Закрепили аминокислоты активного центра и его окрестностей — все, что ближе 7 Å к субстрату, — и сгенерировали 144 варианта, из которых экспрессировались 134, а выход в среднем поднялся в 20 раз. Лучшие из них были в 26 раз активнее и на 40 oC стабильнее [56]. Притом варианты, у которых зафиксировали только активный центр, нарабатывались лучше всех, но не резали ничего. Активность появилась лишь тогда, когда вдобавок закрепили самые консервативные позиции, на которых тоже держалась функция, хоть и не так очевидно.
Половина белка заново
У TEV-протеазы от исходной последовательности оставалось довольно много. Но иногда закреплять можно и совсем чуть-чуть — только то, без чего белок перестает быть собой.
Группа Ивана Гущина из МФТИ взяла CagFbFP — маленький (всего 106 аминокислот) флуоресцентный белок из термофильной бактерии Chloroflexus aggregans [57]. Такие белки полезны тем, что светятся за счет связанного флавина, и если GFP для созревания хромофора нужен кислород, то CagFbFP может светиться и без него в анаэробных условиях: в кишечной биоте, в глубине биопленок, в условиях гипоксии опухолевой ткани. Вдобавок они втрое меньше GFP и быстрее сворачиваются.
Исследователи зафиксировали 20 аминокислот, контактирующих с флавином, а остальное отдали сети на редизайн. Получившиеся белки совпадали с исходным лишь на 55–66% — это уже не вариант белка, а его дальний родственник, которого в природе никогда не было. Все три проверенных варианта нарабатывались, связывали флавин и светились, сохранив при этом и термостабильность, и остальные свойства оригинала [57].
Мембранные белки — самая неудобная группа: вне липидного бислоя они разворачиваются и слипаются. При этом рецепторы, каналы, транспортеры составляют огромную долю мишеней современных лекарств. Их моделирование в бислое, дизайн лигандов и растворимых двойников тянут на отдельную полноценную статью, поэтому во врезке ниже мы разберем лишь один из подходов.
iCASE: чем платят за прочность подвижные ферменты
Подбирая более надежную последовательность, мы часто делаем белок жестче. Ферменту под жесткие промышленные условия это только на пользу, но у многих белков работа сильно зависит от подвижности конструкции: петли над активным центром открываются и закрываются, домены сходятся, карман подстраивается под субстрат. Зацементировать такую молекулу — значит ее выключить. Чтобы решить эту проблему, в iCASE попробовали с помощью молекулярной динамики подсмотреть, какие участки в белке более подвижные [59]. Для этого проводят МД под разным давлением и смотрят, какие участки поддаются легче всего: с них и начинается плавление белка. Потом отдельно толкают активный центр — и те области, которые были механически с ним связаны, как правило, тоже шевельнутся. Через них до активного центра дотянется любое возмущение снаружи и нарушит его работу. Поэтому есть смысл такие податливые области белка укрепить — несколько замен не нарушат подвижность активного центра в целом, но подопрут конструкцию там, где она первой начинает разъезжаться при нагреве.
Так отобрали девять одиночных замен для ПЭТ-гидролазы, и все девять подняли активность. Лучшая из замен к тому же сделала фермент в 11 раз активнее и на 7,5 oC стабильнее [59]. Полезно это тем, что подступиться фермент может только к аморфным участкам, и, чтобы кристаллическая ПЭТ размягчилась и открылась, реактор надо греть примерно до 70 oC. При такой температуре природный фермент уже разваливается, а улучшенная ПЭТ-гидролаза съедает пленку пластика при тех же 70 oC за 12 часов почти целиком.
Тем же способом взялись за щелочную ксиланазу, которую сделали более устойчивой к щелочи и нагреву. Ею на целлюлозно-бумажном производстве обрабатывают массу перед отбеливанием, чтобы обойтись меньшим количеством хлорки. Также улучшили еще трех промышленных работяг: трансглутаминазу (склеивает кусочки мяса и рыбы в цельные куски), лакказу (обесцвечивает красители в стоках текстильных фабрик) и глутаматдекарбоксилазу (ею из глутамата нарабатывают ГАМК для пищевых добавок) [59].
MaSIF: редизайн поверхности
ProteinMPNN уже неявно позволял оптимизировать поверхность — самую вариативную часть белка. Но можно взяться за редизайн поверхности еще более прицельно: основу формы оставим как есть, а поработаем только с наружным слоем молекулы, обращенным к растворителю и к соседям. Этим занимается MaSIF [60].
Возьмем поверхность белка и развернем ее в плоскую геодезическую «фотографию», где у каждого пятнышка будут прописаны форма (бугорок это или ямка) и свойства (заряд, гидрофобность). Дальше эту «фотографию» прогоняют через сверточную нейросеть, как при распознавании предметов на картинках, только на снимке узнается рельеф и заряд участка.
Хороший байндер — это белок, чья поверхность складывается с мишенью, как ключ с замком: к нашему бугорку — их ямка, к плюсу — минус. Модель выискивает такие зеркально подходящие кусочки, сажает их на готовый маленький каркас из природного белка и переписывает вокруг них всю обращенную к мишени поверхность. Белка с такой поверхностью в природе никогда не существовало (рис. 16).
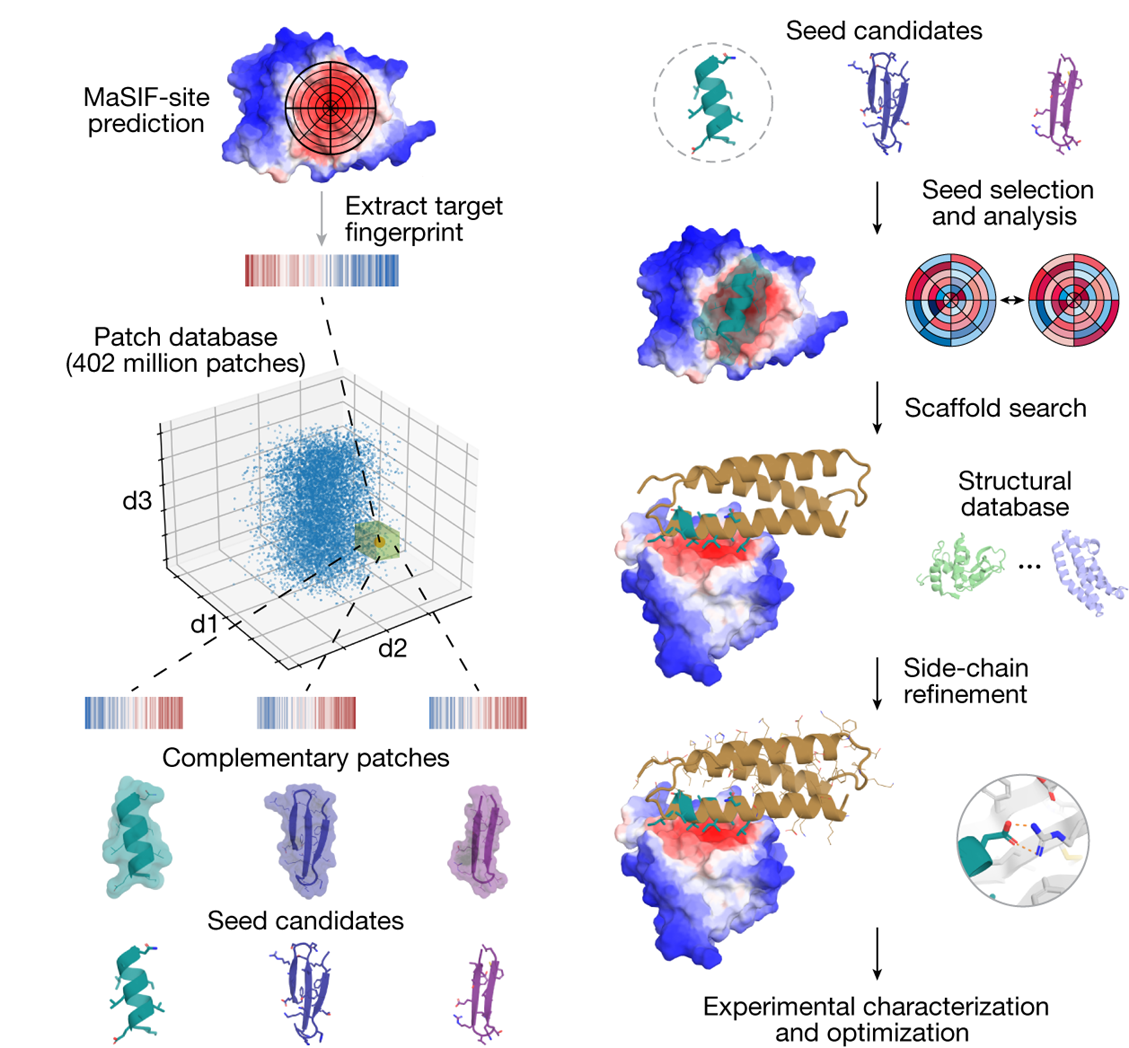
Рисунок 16. Подбор зеркального ключа к поверхности мишени. Поверхность белка-мишени разворачивают в геодезическую карту и считывают свертками ее свойства (бугорки/ямки, заряды и гидрофобность). По этому кусочку из огромной библиотеки подбираются зеркальные кусочки-заготовки, которые идеально совпадут с мишенью как ключ к замку. В итоге модель ищет под них каркас, и получается готовый белок-байндер.
Причем управлять поверхностью можно как душе угодно: например, спроектировать байндер, который вцепится в белок только тогда, когда тот связан с лекарством, — получится этакий молекулярный переключатель (рис. 17). Так получили байндеры к Bcl-2 с венетоклаксом (противолейкозным препаратом), а также к комплексам с прогестероном и антибиотиком актинонином — все с высокой аффинностью и специфичностью [60]. На переключателе с венетоклаксом собрали разрезанный надвое CAR — рецептор, которым вооружают T-клетки против опухоли. Половинки соединяются только в присутствии препарата, и в культуре T-лимфоциты убивали мишень лишь после его добавления. Обычные CAR-T нельзя ни притормозить, ни выключить: клетки живут и работают, пока находят мишень [61]. Отсюда и самые тяжелые осложнения терапии, когда армия лимфоцитов бесконтрольно начинает выбрасывать огромное количество цитокинов, и начинается цитокиновый шторм.
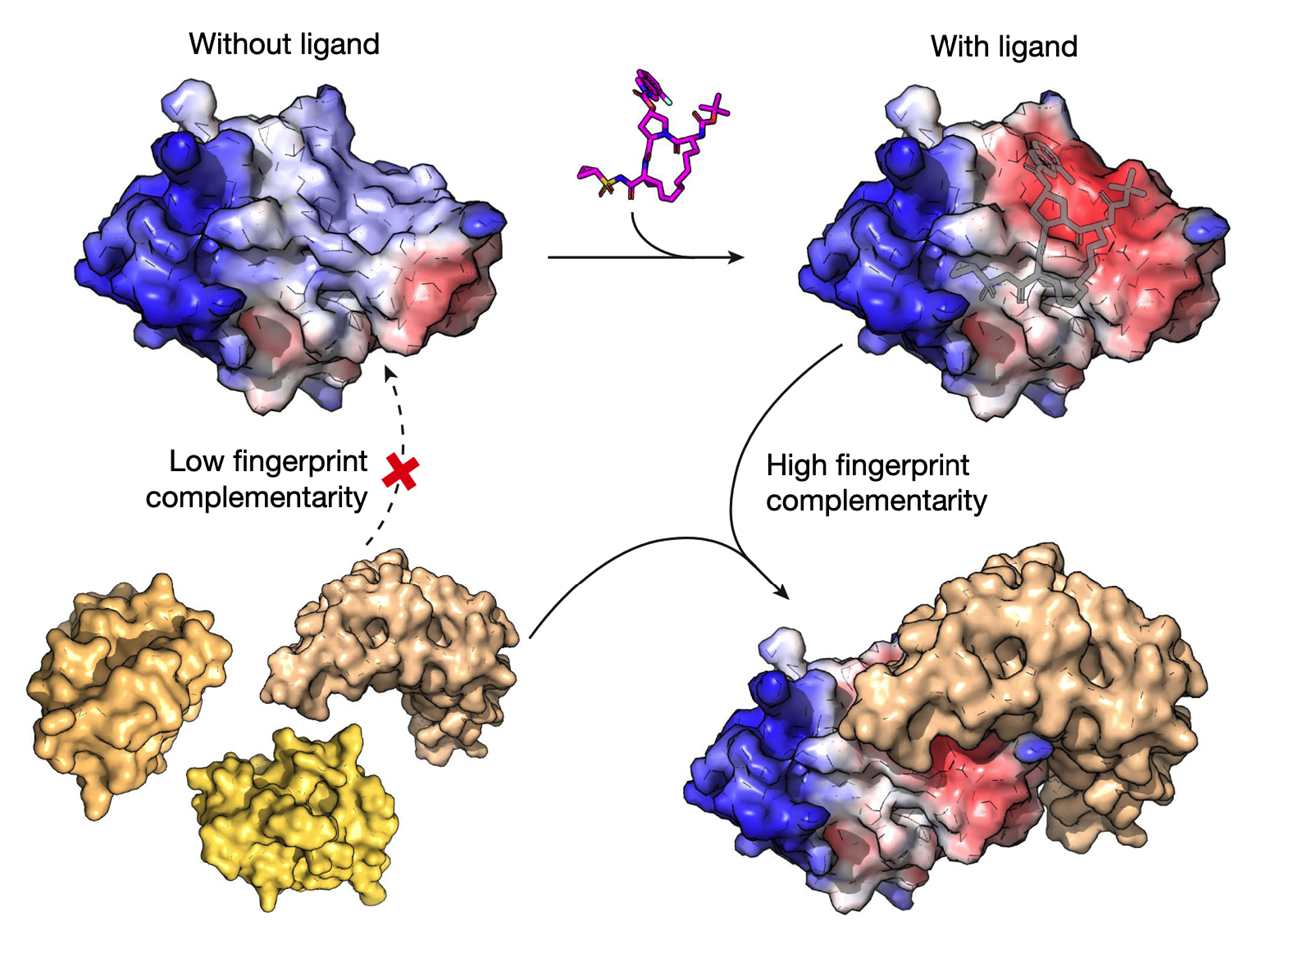
Рисунок 17. Байндер, который срабатывает только в присутствии лекарства. Связывание байндера происходит только когда мишень (красно-синяя) связана с лигандом.
SPURS: стереозрение
ProteinMPNN переписывал все, в том числе важные для работы области, тем самым рискуя убить активность белка. Поэтому в каждом примере перед запуском кто-то размечал важные участки остова вручную: семь ангстрем вокруг субстрата у TEV-протеазы, двадцать остатков вокруг флавина у CagFbFP, карман ретиналя у бактериородопсина [56–58]. Это работает, пока мы знаем, что в белке ответственно за функцию, и зачастую это не только активный центр. Есть и менее очевидные участки, переписав которые, можно сломать функцию белка. Так было на примере той же TEV-протеазы, функция которой держалась еще и на консервативных позициях, ничем не выделяющихся на структуре, — их пришлось вылавливать по выравниванию гомологов.
Так же работал PROSS, отбиравший только одобренные эволюцией замены, и так же устроена карта толерантности языковой модели — консервативная позиция получит более высокую вероятность [22], [32]. Вот только это ничего не говорит о причине: аминокислоту могли беречь потому, что на ней держится укладка, а могли — потому, что на ней держится работа. Более того, каталитические остатки укладке обычно мешают: заряд посреди гидрофобного ядра, вывернутая конформация — эволюция здесь жертвовала прочностью ради активности: тот самый trade-off, с которого мы начинали. Значит, графовая сеть, заточенная на сохранение укладки, в таком месте не просто промолчит, а прямо предложит заменить и укрепить. Таким образом, если вычесть из консервативных остатков стабилизирующие, — останутся только те, от которых зависит функция. На этом противоречии и работает SPURS.
Таким приемом у алкогольдегидрогеназы модель нашла три остатка, удерживающих каталитический цинк, а у SH3-домена — поверхность, которой он ловит пептид. У SAM-домена модель нашла интерфейс димеризации, у MBD-домена — остатки, которыми тот садится на ДНК [62]. Именно этого не хватало геометрическому редизайну.
Переписывая белок вслепую, легко получить прочный, отлично нарабатывающийся и совершенно бесполезный булыжник, как было с TEV-протеазой поначалу. Раньше разметку, куда лезть не стоит, приходилось брать из того, что мы про белок и так знаем, — а теперь ее можно получить и у молекулы, про которую неизвестно почти ничего (рис. 19).
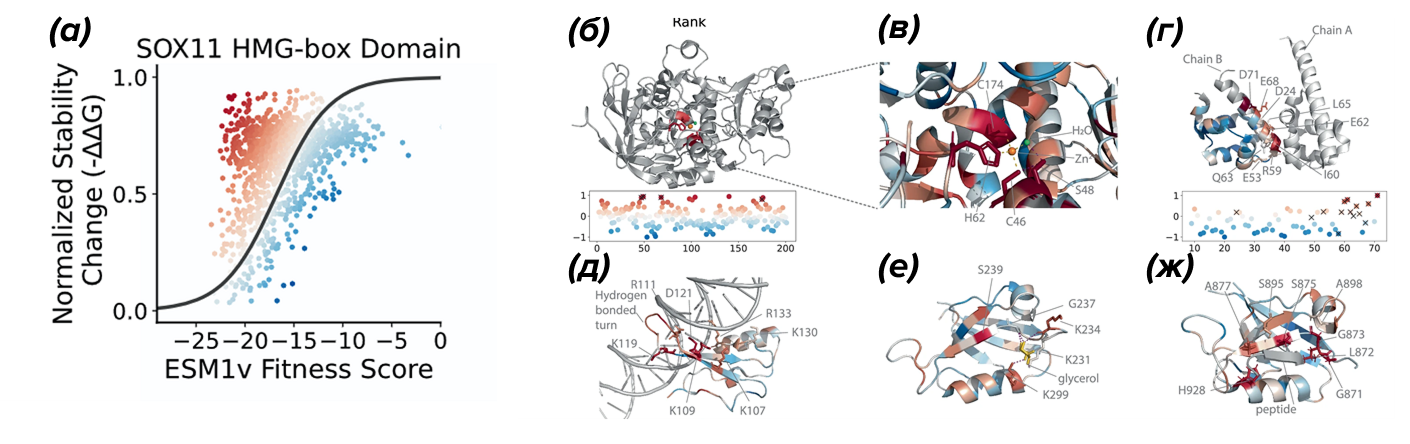
Рисунок 19. Там, где два взгляда спорят, прячется функция. (а) — каждая точка — одиночная замена в ДНК-связывающем домене HMG-box белка SOX11. Красные точки — мутации, бьющие по функции: физически они не вредят и SPURS предсказывает даже прирост стабильности (-ΔΔG Stability Change), а эволюция их все равно отбраковывает — ESM показывает падение правдоподобия (fitness score).
(б—ж) — в те же цвета раскрасили другие домены: красным подсвечены функциональные центры (каталитический сайт с ионом цинка, поверхности связывания ДНК и белков-партнеров). Красные мутации могут быть связаны с наследственными заболеваниями — например, мутации в (д) MBD-домене MECP2 вызывают синдром Ретта.
Кроме того, мы можем попробовать объяснить механизмы патогенности мутаций у пациентов. Если ранее мы ориентировались преимущественно на эволюционные оценки правдоподобия (как в EVE), то теперь можно не только сказать, что мутация вредоносная, но и примерно понять почему: либо она расшатывает структуру белка, либо попадает в функционально важный участок.
Итог: пространства редизайна
Всю статью мы, по сути, занимались одним и тем же — управляли эволюцией, перенесенной из пробирки в компьютер. Менялись две вещи: насколько далеко мы видели и в каком пространстве двигались.
Начали с пространства последовательностей. Языковые модели, изучившие эволюционный архив, расставили в нем фонари: карта толерантности показывала, какую букву эволюция поставила бы в этой позиции. Слепой перебор превратился в дешевую симуляцию отбора — но вела она к живому белку, а не к нужному.
Тогда мы подкрасили это же пространство собственными измерениями, а оценщик докрасил остальное предсказанными — и ориентироваться по компасу стало удобнее. Полтора десятка проверенных в лаборатории вариантов хватало, чтобы маленькая модель поверх эмбеддингов начала различать не «жизнеспособное и мертвое», а «плохое и хорошее» по нашей мерке: снаружи это компас EVOLVEpro, внутри модели — термометр PRIME. MODIFY развел стартовые точки подальше друг от друга, чтобы не кружить вокруг одного варианта, а ProteinNPT научился выжимать из накопленного журнала все до капли.
Потом мы вышли из букв в латентное пространство: автокодировщик сжал семейство в координаты, и по этому полю стало можно гулять, получая за один шаг сразу десяток согласованных замен. А прочитанная наоборот карта стала инструментом для клинической генетики.
Наконец, опорой стала форма. ProteinMPNN перестал искать вариант по адресу и начал пересобирать белок по чертежу: TEV-протеаза, флуоресцентный белок без кислорода, растворимый двойник мембранного насоса. iCASE научился выбирать позиции, глядя на подвижность, MaSIF взялся за поверхность, а SPURS свел оба взгляда в одну модель и стал показывать, куда лезть не стоит.
По дороге постепенно стерлась и грань между редизайном и дизайном de novo. Сначала мы меняли в природном ферменте одну аминокислоту, потом десятки за шаг, а в пространстве форм счет пошел на целые области молекулы — и в какой-то момент от исходного белка осталась скорее идея, чем последовательность.
Чего мы пока не умеем
Главное ограничение — картинка статична. Почти все эти модели смотрят на застывший снимок, а белок в растворе дышит. iCASE уже пробовал подмешивать в разметку короткую молекулярную динамику, но полноценной кинетики это не дает (подробнее про МД — в статье «Молекулярная динамика биомолекул» [65]). Отсюда же и тот размен, который тянется через всю статью: геометрический редизайн делает конструкцию жестче, и расплачиваться за это приходится активностью. Вычислительно этот баланс до сих пор никто не научился держать, и его по-прежнему проверяют в пробирке.
Не решен и вопрос окружения. Модели чаще всего видят одну цепь без партнеров, лигандов и мембраны. Кое-что уже существует: LigandMPNN умеет учитывать кофакторы, SPURS угадывает интерфейсы, а AlphaFold 3 умеет предсказывать структуру белка сразу вместе с лигандом, ионом или нуклеиновой кислотой [66], [67]. Но предсказать готовый комплекс и спроектировать белок под этот комплекс — все еще разные задачи.
Зато постепенно меняется то, как мы этими моделями пользуемся. Ни одна из них не закрывает задачу целиком: одна ранжирует замены, другая переписывает по остову, третья говорит, куда лезть не стоит, — каждая смотрит на белок из своего пространства, и собирать из них цепочку приходится вручную. Сегодня поверх этого набора начинают надстраивать агентов: языковая модель читает словесное описание задачи и выходы самих предикторов, сама решает, кому можно доверять больше, и отсеивает кандидатов. Для нуклеазы Cas12i3 такой агент отобрал тридцать замен, и четырнадцать из них оказались активнее исходного фермента, а лучшие — в четыре и пять раз [67]. Правда, устроено все это поверх коммерческих языковых моделей, так что за каждый запуск придётся заплатить.
И все же расклад изменился принципиально. Направленная эволюция перебирала тысячи вариантов вслепую; сегодня в лабораторию уходят десятки — отобранные, объяснимые и часто попадающие с первого раза. Слепой дрейф в тумане за несколько лет превратился в навигацию, и каждая следующая модель отбирала у хаоса еще немного контроля. А там, где эволюционная карта обрывается, где от исходного белка не остаётся ни последовательности, ни формы, ни даже идеи, — редизайн превращается в дизайн de novo [3].
Литература
- Молекулярная поверхность: что в облике тебе моём?;
- Adi Goldenzweig, Sarel J. Fleishman. (2018). Principles of Protein Stability and Their Application in Computational Design. Annu. Rev. Biochem.. 87, 105-129;
- От структуры к функции: революция ИИ в белковом дизайне;
- Несуществующие в природе белки́ — за что вручили Нобелевскую премию по химии (2024);
- Проблема фолдинга белка;
- Роль слабых взаимодействий в биополимерах;
- D A Estell, T P Graycar, J A Wells. (1985). Engineering an enzyme by site-directed mutagenesis to be resistant to chemical oxidation.. Journal of Biological Chemistry. 260, 6518-6521;
- Nobuhiko Tokuriki, Dan S Tawfik. (2009). Stability effects of mutations and protein evolvability. Current Opinion in Structural Biology. 19, 596-604;
- Война и мир: как устроить белковую жизнь?;
- В диких условиях: как жил последний всеобщий предок LUCA;
- «Элементы»: «LUCA стал древнее и при этом сложнее»;
- 12 методов в картинках: полимеразная цепная реакция;
- Raine E.S. Thomson, Saskya E. Carrera-Pacheco, Elizabeth M.J. Gillam. (2022). Engineering functional thermostable proteins using ancestral sequence reconstruction. Journal of Biological Chemistry. 298, 102435;
- Marcela Helena Gambim Fonseca, Tayná da Silva Fiúza, Stephanie Bath de Morais, Tatiana de Arruda Campos Brasil de Souza, Raphael Trevizani. (2021). Circumventing the side effects of L-asparaginase. Biomedicine & Pharmacotherapy. 139, 111616;
- Лекарства от психических расстройств: как не сойти с ума в эпоху современной фармакологии?;
- Reinhold Tacke, Friedrich Popp, Barbara Müller, Bastian Theis, Christian Burschka, et. al.. (2008). Sila‐Haloperidol, a Silicon Analogue of the Dopamine (D 2 ) Receptor Antagonist Haloperidol: Synthesis, Pharmacological Properties, and Metabolic Fate. ChemMedChem. 3, 152-164;
- S. B. Jennifer Kan, Russell D. Lewis, Kai Chen, Frances H. Arnold. (2016). Directed evolution of cytochrome c for carbon–silicon bond formation: Bringing silicon to life. Science. 354, 1048-1051;
- Черный ящик изобилия. Нобелевская премия по химии 2018 года;
- Биотехнология антител;
- Конструкторское бюро белков;
- Daniela Röthlisberger, Olga Khersonsky, Andrew M. Wollacott, Lin Jiang, Jason DeChancie, et. al.. (2008). Kemp elimination catalysts by computational enzyme design. Nature. 453, 190-195;
- Adi Goldenzweig, Moshe Goldsmith, Shannon E. Hill, Or Gertman, Paola Laurino, et. al.. (2016). Automated Structure- and Sequence-Based Design of Proteins for High Bacterial Expression and Stability. Molecular Cell. 63, 337-346;
- Ivan Campeotto, Adi Goldenzweig, Jack Davey, Lea Barfod, Jennifer M. Marshall, et. al.. (2017). One-step design of a stable variant of the malaria invasion protein RH5 for use as a vaccine immunogen. Proc. Natl. Acad. Sci. U.S.A.. 114, 998-1002;
- Как языковые модели покорили мир белков;
- История развития искусственного интеллекта и его пришествия в биологию;
- AlphaFold 3: как диффузионные модели пришли в предсказание структуры белков;
- Эволюция как векторное поле: подход evo-velocity в анализе белков;
- Яды — высокоточное оружие: компьютерное исследование природных нейротоксинов;
- Три поколения лекарств;
- Краткая история открытия и применения антител;
- Антитело: лучший способ распознать чужого;
- Brian L. Hie, Varun R. Shanker, Duo Xu, Theodora U. J. Bruun, Payton A. Weidenbacher, et. al.. (2024). Efficient evolution of human antibodies from general protein language models. Nat Biotechnol. 42, 275-283;
- Matthew I. J. Raybould, Claire Marks, Konrad Krawczyk, Bruck Taddese, Jaroslaw Nowak, et. al.. (2019). Five computational developability guidelines for therapeutic antibody profiling. Proc. Natl. Acad. Sci. U.S.A.. 116, 4025-4030;
- Tushar Jain, Tingwan Sun, Stéphanie Durand, Amy Hall, Nga Rewa Houston, et. al.. (2017). Biophysical properties of the clinical-stage antibody landscape. Proc. Natl. Acad. Sci. U.S.A.. 114, 944-949;
- Richard W. Shuai, Jeffrey A. Ruffolo, Jeffrey J. Gray. (2023). IgLM: Infilling language modeling for antibody sequence design. Cell Systems. 14, 979-989.e4;
- Tobias H. Olsen, Fergus Boyles, Charlotte M. Deane. (2022). Observed Antibody Space: A diverse database of cleaned, annotated, and translated unpaired and paired antibody sequences. Protein Science. 31, 141-146;
- Birkir Reynisson, Bruno Alvarez, Sinu Paul, Bjoern Peters, Morten Nielsen. (2020). NetMHCpan-4.1 and NetMHCIIpan-4.0: improved predictions of MHC antigen presentation by concurrent motif deconvolution and integration of MS MHC eluted ligand data. Nucleic Acids Research. 48, W449-W454;
- Sameer Khurana, Reda Rawi, Khalid Kunji, Gwo-Yu Chuang, Halima Bensmail, Raghvendra Mall. (2018). DeepSol: a deep learning framework for sequence-based protein solubility prediction. Bioinformatics. 34, 2605-2613;
- Brennan Abanades, Guy Georges, Alexander Bujotzek, Charlotte M Deane. (2022). ABlooper: fast accurate antibody CDR loop structure prediction with accuracy estimation. Bioinformatics. 38, 1877-1880;
- Luis S. Mille-Fragoso, Claudia L. Driscoll, John N. Wang, Haoyu Dai, Talal Widatalla, et. al.. (2026). Efficient generation of epitope-targeted antibodies with Germinal. Nat Biotechnol;
- Белковые галлюцинации: как справляется AlphaFold?;
- Dreyer F., Cutting D., Schneider C., Kenlay H., Deane C. (2023). Inverse folding for antibody sequence design using deep learning. ArXiv;
- J. Dauparas, I. Anishchenko, N. Bennett, H. Bai, R. J. Ragotte, et. al.. (2022). Robust deep learning–based protein sequence design using ProteinMPNN. Science. 378, 49-56;
- Kaiyi Jiang, Zhaoqing Yan, Matteo Di Bernardo, Samantha R. Sgrizzi, Lukas Villiger, et. al.. (2025). Rapid in silico directed evolution by a protein language model with EVOLVEpro. Science. 387;
- Fan Jiang, Mingchen Li, Jiajun Dong, Yuanxi Yu, Xinyu Sun, et. al.. (2024). A general temperature-guided language model to design proteins of enhanced stability and activity. Sci. Adv.. 10;
- Liqi Kang, Banghao Wu, Bingxin Zhou, Pan Tan, Yun (Kenneth) Kang, et. al.. (2025). AI-enabled alkaline-resistant evolution of protein to apply in mass production. eLife. 13;
- Kerr Ding, Michael Chin, Yunlong Zhao, Wei Huang, Binh Khanh Mai, et. al.. (2024). Machine learning-guided co-optimization of fitness and diversity facilitates combinatorial library design in enzyme engineering. Nat Commun. 15;
- Jonathan Weinstein, Olga Khersonsky, Sarel J Fleishman. (2020). Practically useful protein-design methods combining phylogenetic and atomistic calculations. Current Opinion in Structural Biology. 63, 58-64;
- Alex Hawkins-Hooker, Florence Depardieu, Sebastien Baur, Guillaume Couairon, Arthur Chen, David Bikard. (2021). Generating functional protein variants with variational autoencoders. PLoS Comput Biol. 17, e1008736;
- Jonathan Frazer, Pascal Notin, Mafalda Dias, Aidan Gomez, Joseph K. Min, et. al.. (2021). Disease variant prediction with deep generative models of evolutionary data. Nature. 599, 91-95;
- Egbert Castro, Abhinav Godavarthi, Julian Rubinfien, Kevin Givechian, Dhananjay Bhaskar, Smita Krishnaswamy. (2022). Transformer-based protein generation with regularized latent space optimization. Nat Mach Intell. 4, 840-851;
- Nicole N. Thadani, Sarah Gurev, Pascal Notin, Noor Youssef, Nathan J. Rollins, et. al.. (2023). Learning from prepandemic data to forecast viral escape. Nature. 622, 818-825;
- Pascal Notin, Ruben Weitzman, Debora S. Marks, Yarin Gal ProteinNPT: Improving Protein Property Prediction and Design with Non-Parametric Transformers — openRxiv;
- Pascal Notin, Aaron W. Kollasch, Daniel Ritter, Lood van Niekerk, Steffanie Paul, et. al. ProteinGym: Large-Scale Benchmarks for Protein Design and Fitness Prediction — openRxiv;
- Торжество компьютерных методов: предсказание строения белков;
- Kiera H. Sumida, Reyes Núñez-Franco, Indrek Kalvet, Samuel J. Pellock, Basile I. M. Wicky, et. al.. (2024). Improving Protein Expression, Stability, and Function with ProteinMPNN. J. Am. Chem. Soc.. 146, 2054-2061;
- Andrey Nikolaev, Alexander Kuzmin, Elena Markeeva, Elizaveta Kuznetsova, Yury L. Ryzhykau, et. al.. (2024). Reengineering of a flavin‐binding fluorescent protein using
ProteinMPNN . Protein Science. 33; - Andrey Nikolaev, Yaroslav Orlov, Fedor Tsybrov, Elizaveta Kuznetsova, Pavel Shishkin, et. al.. (2025). Engineering of soluble bacteriorhodopsin. Chem. Sci.. 16, 11067-11076;
- Nan Zheng, Yongchao Cai, Zehua Zhang, Huimin Zhou, Yu Deng, et. al.. (2025). Tailoring industrial enzymes for thermostability and activity evolution by the machine learning-based iCASE strategy. Nat Commun. 16;
- Anthony Marchand, Stephen Buckley, Arne Schneuing, Martin Pacesa, Maddalena Elia, et. al.. (2025). Targeting protein–ligand neosurfaces with a generalizable deep learning tool. Nature. 639, 522-531;
- Многоликий CAR-рецептор: новые клетки, новые цели;
- Ziang Li, Yunan Luo. (2025). Generalizable and scalable protein stability prediction with rewired protein generative models. Nat Commun. 17;
- Kotaro Tsuboyama, Justas Dauparas, Jonathan Chen, Elodie Laine, Yasser Mohseni Behbahani, et. al.. (2023). Mega-scale experimental analysis of protein folding stability in biology and design. Nature. 620, 434-444;
- Harini Narayanan, J. Christopher Love. (2026). Pichia-CLM: A language model–based codon optimization pipeline for Komagataella phaffii. Proc. Natl. Acad. Sci. U.S.A.. 123;
- Молекулярная динамика биомолекул. Часть III. От перфокарт до ИИ;
- Josh Abramson, Jonas Adler, Jack Dunger, Richard Evans, Tim Green, et. al.. (2024). Accurate structure prediction of biomolecular interactions with AlphaFold 3. Nature. 630, 493-500;
- Tan Y.,Yu Y., Wu C., Zhong B., Li M., Fan G., Zhu J., Liang Y., Dong N., Hong L. (2026). Rank-and-Reason: Multi-Agent Collaboration Accelerates Zero-Shot Protein Mutation Prediction. ArXiv;
- Igor D. Zlotnikov, Alexander A. Ezhov, Alexander V. Borisov, Andrey V. Lukyanov, Denis A. Babkov, Elena V. Kudryashova. (2025). Liposomal Formulations of L-Asparaginase Conjugated with Cationic Polymers for Enhanced Internalization into Cancer Cells. Macromol. 5, 54;
- Igor D. Zlotnikov, Elena V. Kudryashova. (2024). Targeted Polymeric Micelles System, Designed to Carry a Combined Cargo of L-Asparaginase and Doxorubicin, Shows Vast Improvement in Cytotoxic Efficacy. Polymers. 16, 2132;
- Anastasiya N. Shishparenok, Yulia A. Gladilina, Marina V. Pokrovskaya, Svetlana S. Aleksandrova, Sergey V. Kraevsky, et. al.. (2026). Immobilization of l-asparaginase on oxidized bacterial cellulose to enhance stability and cytotoxic activity. International Journal of Biological Macromolecules. 339, 149992;
- Igor D. Zlotnikov, Alexander A. Vinogradov, Elena V. Kudryashova. (2026). AI-Driven Secondary Immunomodulatory Effects of Conventional Drugs on Patient-Derived Macrophages. IJMS. 27, 3894;
- Igor D. Zlotnikov, Alexander A. Ezhov, Elena V. Kudryashova. (2026). A Glycan-Based Ligands for Phenotypic Profiling and Selective Immunomodulation of Alveolar Macrophage for Resolution of Inflammation. Immuno. 6, 9;
- Igor D. Zlotnikov, Natalia I. Kolganova, Shamil A. Gitinov, Dmitry Y. Ovsyannikov, Elena V. Kudryashova. (2025). The Role of CD68+ Cells in Bronchoalveolar Lavage Fluid for the Diagnosis of Respiratory Diseases. Immuno. 5, 43;
- Igor D. Zlotnikov, Elena V. Kudryashova. (2024). Polymeric Infrared and Fluorescent Probes to Assess Macrophage Diversity in Bronchoalveolar Lavage Fluid of Asthma and Other Pulmonary Disease Patients. Polymers. 16, 3427.


Комментарии
0Чтобы оставить комментарий, необходимо
войти